Grundlagen
Wie SpatialAgents arbeiten.
Dreizehn Abschnitte führen vom Begriff des Coding-Agenten bis zum gemessenen Ergebnis. Sie richten sich an alle, die mit QGIS arbeiten und wissen wollen, was zwischen Auftrag und Karte geschieht. Jeder Abschnitt hat eine Grafik, einen Text und die Hörfassung dazu; das Hören dauert zusammen etwa eine Viertelstunde.
Übersicht
Dreizehn Abschnitte in vier Gruppen.
Die Reihenfolge führt vom Begriff über den Fachkontext zum System und endet beim Beleg.
- 01Was ist ein Coding-Agent?Grundbegriff
- 02WerkzeugaufrufGrundbegriff
- 03Kommandozeile und Open-Source-GISGrundbegriff
- 04MCP-ServerGrundbegriff
- 05InstruktionsdateienFachkontext
- 06SkillsFachkontext
- 07Agentische PlanungFachkontext
- 08Der Ablauf einer AufgabeSystem
- 09Geospatial API und TokeneffizienzSystem
- 10Plugin und BridgeSystem
- 11Steuern und RechnenSystem
- 12Lokal oder CloudBetrieb und Beleg
- 13Belege durch MessreihenBetrieb und Beleg
Hörfassung insgesamt: 20 min 18 s.
Konzept 01 · Grundbegriff
Was ist ein Coding-Agent?
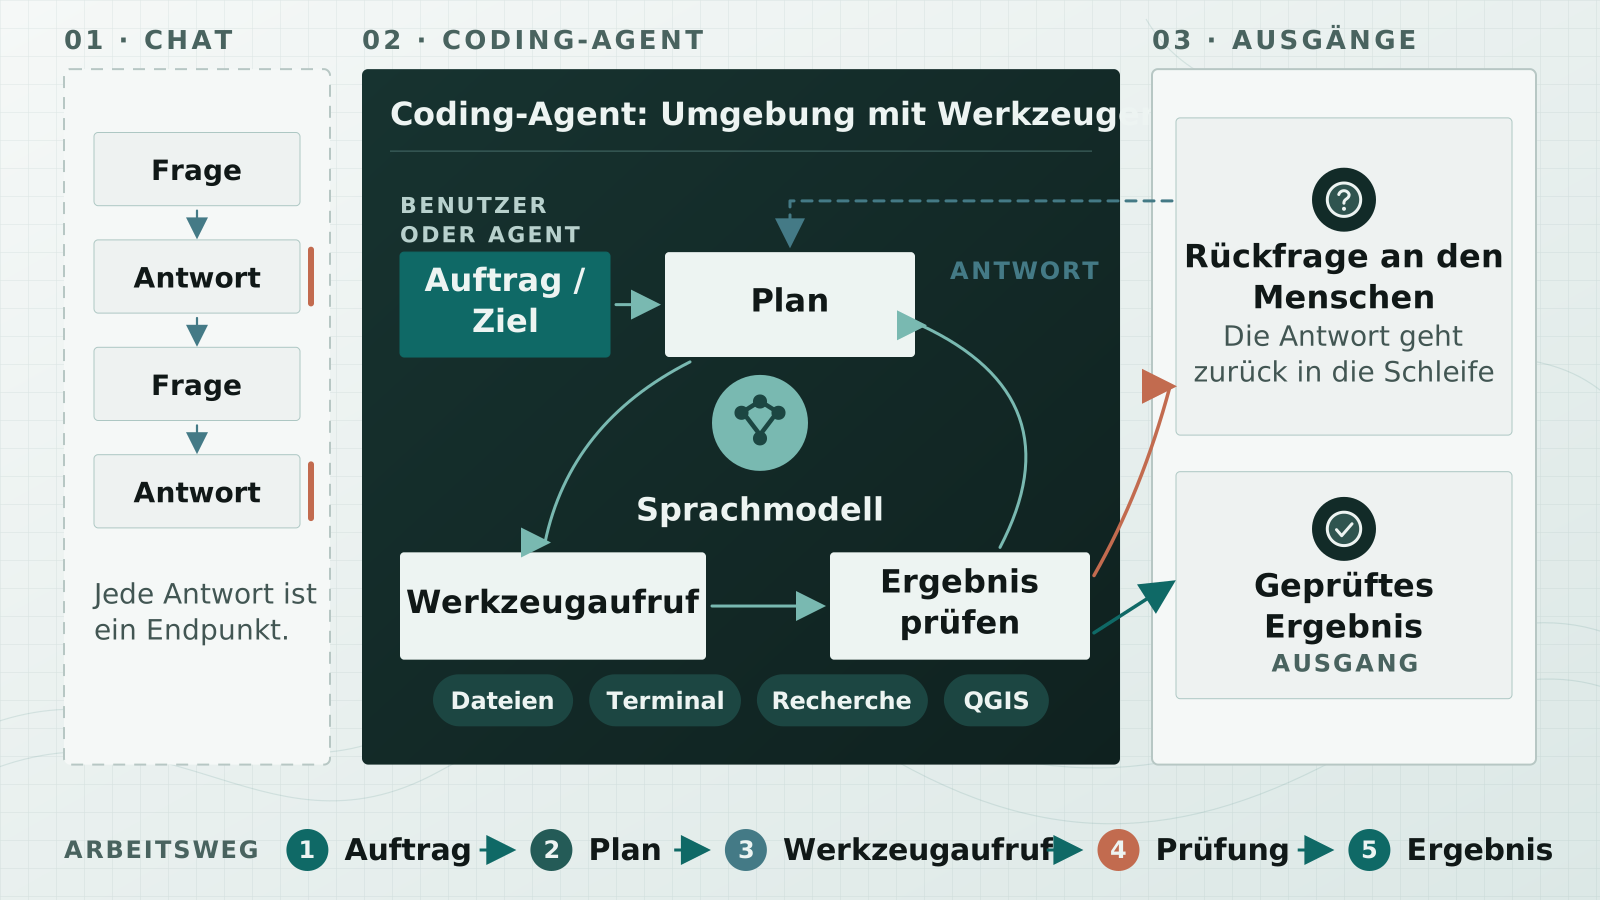
Ein Chat verläuft als Kette aus Frage und Antwort, und jede Antwort ist ein Endpunkt.
Ein Coding-Agent ist kein Sprachmodell, sondern eine Arbeitsumgebung, in die ein Sprachmodell eingebettet ist. Die Umgebung stellt die Werkzeuge bereit, also Dateien lesen und schreiben, Kommandos ausführen und nachschlagen. Und sie stellt die Schleife bereit, die vom Auftrag über den Plan zum Werkzeugaufruf führt, das Ergebnis prüft und zum Plan zurückkehrt.
In dieser Schleife plant das Modell, ruft ein Werkzeug auf und liest das Ergebnis. Trägt der erste Weg nicht, probiert es einen anderen und plant neu.
Die Schleife endet an einem geprüften, brauchbaren Ergebnis oder an einer Rückfrage an den Menschen. Eine Prüfung allein beendet sie nicht, und nach einer Antwort läuft sie weiter.
Ein einzelner Lauf kann mehrere hundert Werkzeugaufrufe umfassen und über zwei Stunden dauern, ohne dass jemand eingreift. Die Erlaubnis dazu wird einmal am Anfang erteilt, nicht bei jedem Schritt.
Solche Umgebungen muss niemand selbst bauen, es gibt sie fertig.
Belege
Konzept 01 · Teil 2
Drei Coding-Agenten: Claude Code, Codex CLI, OpenCode
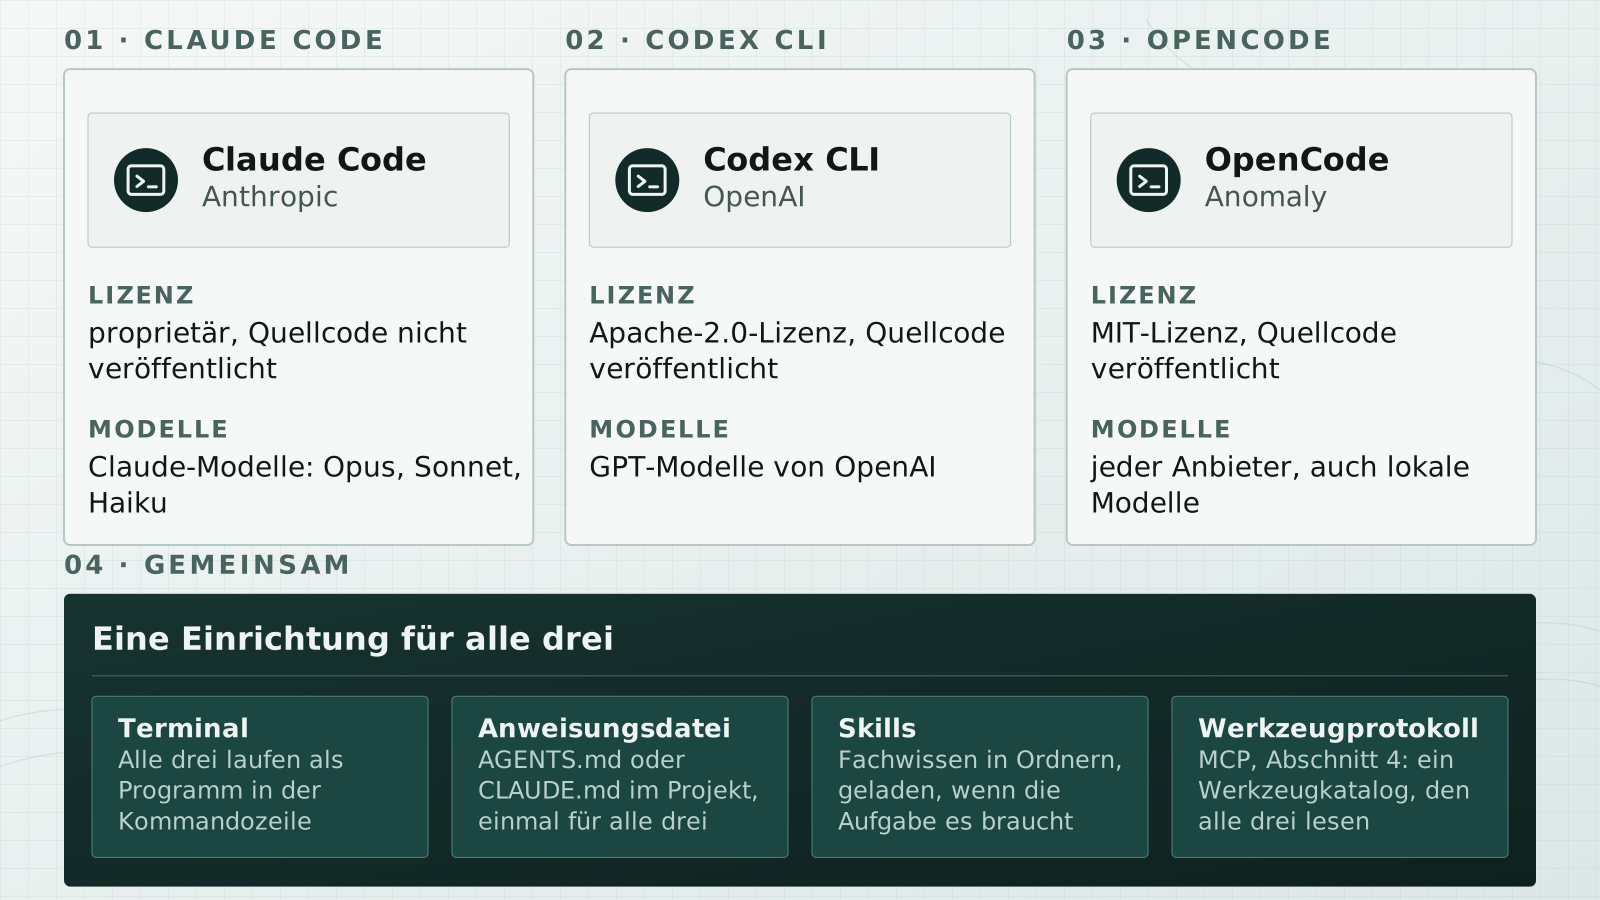
SpatialAgents arbeiten mit drei fertigen Coding-Agenten.
Claude Code kommt von Anthropic; der Quellcode ist nicht veröffentlicht, und es arbeitet mit den Claude-Modellen. Codex kommt von OpenAI, der Quellcode ist frei unter der Apache-2.0-Lizenz, und es arbeitet mit den GPT-Modellen. OpenCode kommt von Anomaly, ebenfalls quelloffen unter der MIT-Lizenz; es ist an keinen Anbieter gebunden und arbeitet auch mit einem Modell, das auf dem eigenen Rechner läuft.
Alle drei laufen im Terminal, lesen dieselbe Anweisungsdatei im Projekt, laden Skills und binden Werkzeuge nach demselben Protokoll an. Deshalb reicht eine Einrichtung für alle drei.
In den Messreihen liefen sieben Modelle, die im Weiteren mit kurzen Namen genannt werden. Opus, Sonnet und Haiku liefen in Claude Code, Sol, Terra und Luna in Codex, und Qwen als lokales Modell in OpenCode.
Offen ist, wie ein Werkzeugaufruf technisch aussieht.
Belege
Konzept 02 · Grundbegriff
Werkzeugaufruf
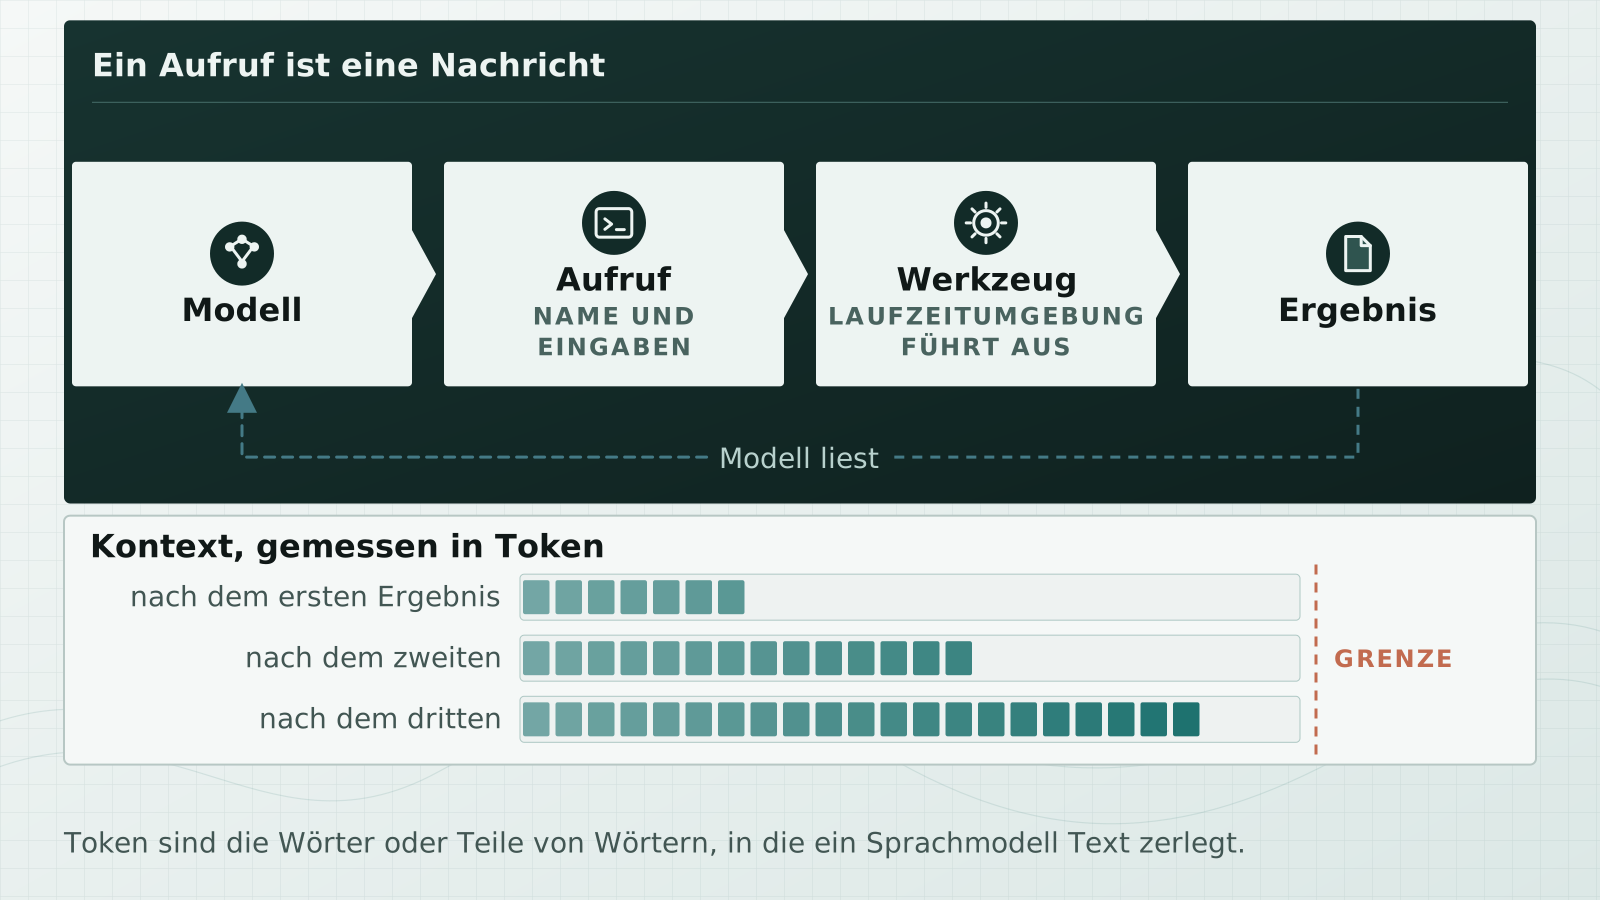
Ein Sprachmodell kann nichts ausführen, es kann nur schreiben. Ein Werkzeugaufruf ist deshalb eine Nachricht mit festem Aufbau, die das Werkzeug und seine Eingaben nennt; die Umgebung führt das Werkzeug aus und schreibt das Ergebnis zurück.
Dieses Ergebnis landet im Kontext, also in dem Text, den das Modell bei jedem Schritt vor sich hat. Der Kontext ist begrenzt.
Gemessen wird er in Token. Ein Token ist ein Wort oder ein Teil eines Wortes, und in solchen Einheiten liest und schreibt ein Sprachmodell.
Jedes Ergebnis belegt einen Teil des Kontexts, deshalb kommt es darauf an, wie viel ein Werkzeug zurückgibt.
Wie viel dabei zusammenkommt, hängt am Modell. Bei derselben Aufgabe reicht der mittlere Verbrauch eines Laufs von drei Millionen bis zu fast hundert Millionen Token, und die höhere Zahl steht nicht für die bessere Karte.
Für Geodaten muss man solche Werkzeuge nicht erst bauen, es gibt sie seit Jahrzehnten.
Belege
Konzept 03 · Grundbegriff
Kommandozeile und Open-Source-GIS
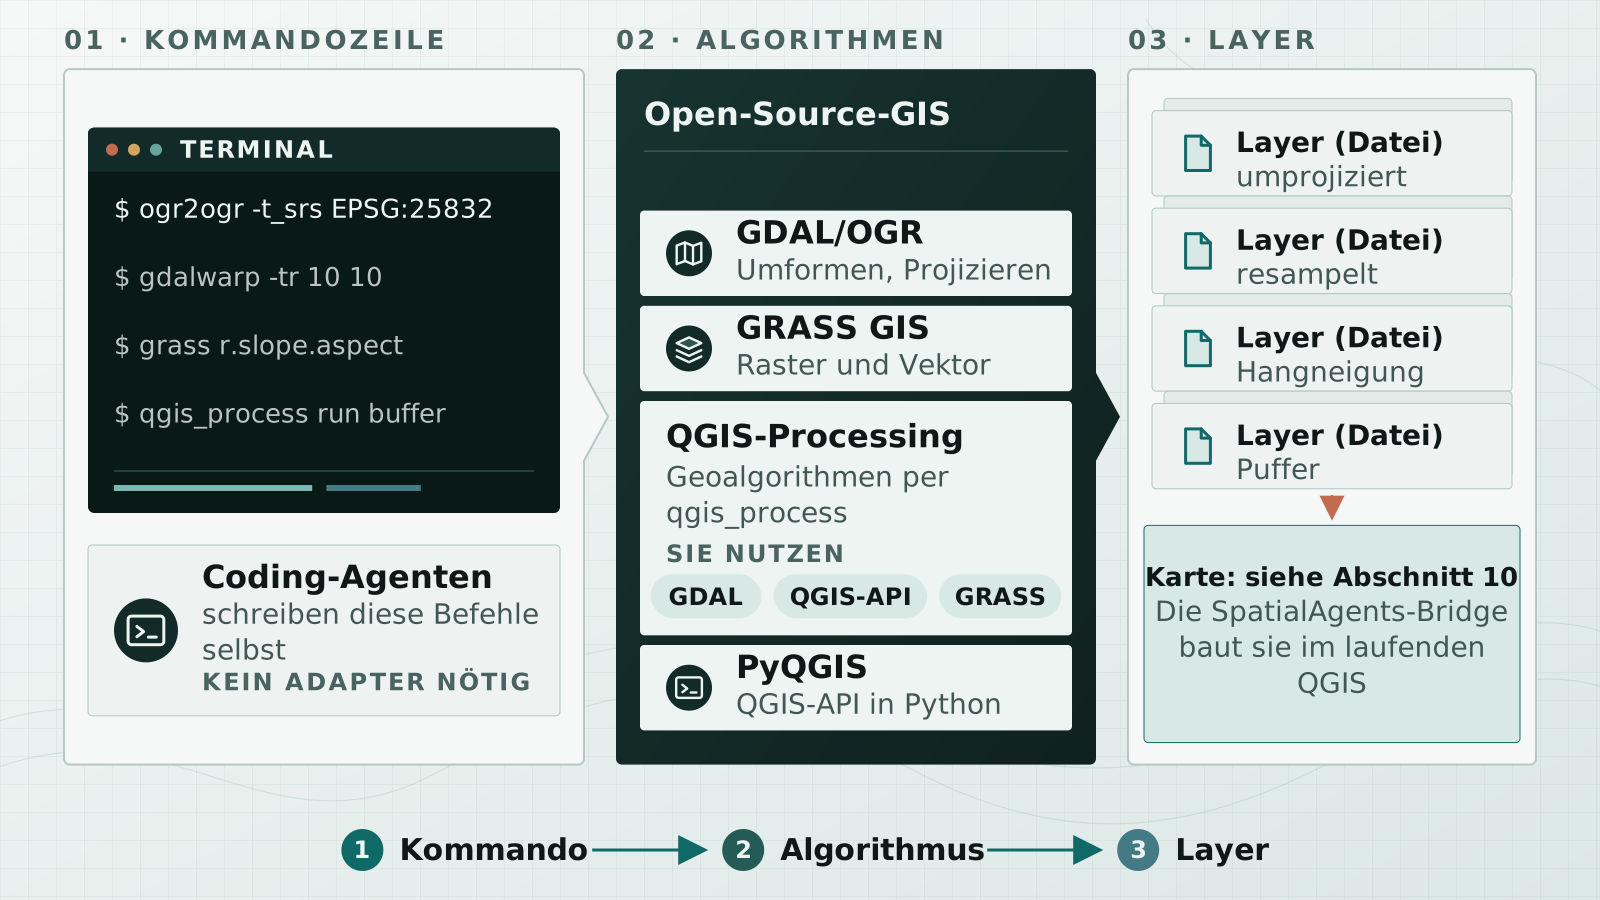
Open-Source-GIS-Werkzeuge haben eine Eigenschaft, die für Agenten entscheidend ist: Man bedient sie mit Text.
Die GIS-Werkzeuge der Kommandozeile lesen, schreiben, projizieren und verschneiden Geodaten mit einem Befehl, und QGIS führt seine eigenen Geoalgorithmen über ein solches Kommando aus. Wer lieber in Python arbeitet, schreibt dieselbe Arbeit mit den GIS-Python-Bibliotheken als Skript.
Ein Coding-Agent schreibt genau solche Kommandos, und ein Übersetzer dazwischen ist nicht nötig, weil das Werkzeug schon da ist.
Was ein solcher Befehl erzeugt, ist eine Datei, die in der Fachsprache Layer heißt, also Datenebene. Eine Datenebene enthält Geometrien oder Rasterzellen und ihre Werte, aber noch kein Bild. Die Karte entsteht erst in QGIS, und das ist ein eigener Schritt.
Damit fehlt noch eines: der Weg zu QGIS selbst.
Belege
Konzept 04 · Grundbegriff
MCP-Server
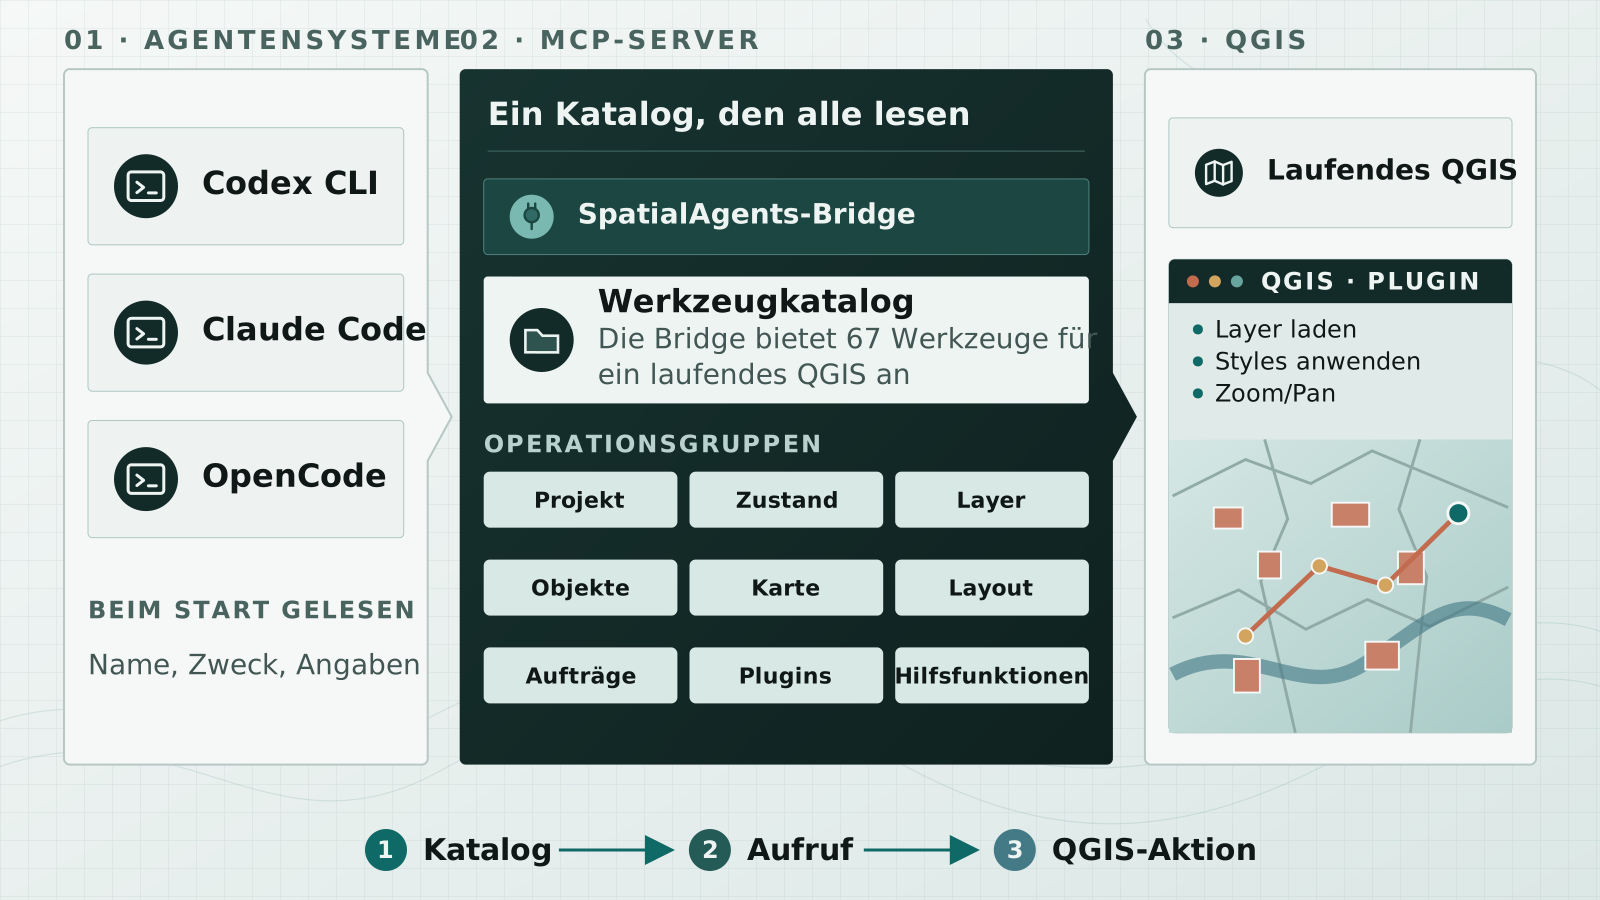
Damit ein Agent eine Anwendung bedienen kann, braucht er eine Liste ihrer Werkzeuge. Das Model Context Protocol, kurz MCP, legt fest, wie eine Anwendung diese Liste bereitstellt.
Jeder Eintrag nennt drei Dinge: den Namen des Werkzeugs, wofür es gut ist und welche Angaben es erwartet.
Ein Agent liest diese Liste, sobald er startet. Von da an steht sie in seinem Kontext, und er weiß, was die Anwendung kann.
Für QGIS gibt es einen solchen Server, die SpatialAgents-Bridge. Sie bietet 67 Werkzeuge an, geordnet in neun Gruppen. Die reichen vom Öffnen eines Projekts und dem Lesen seines Zustands über das Laden von Layern und das Abfragen ihrer Objekte bis zur Karte, zum Druck-Layout und zu länger laufenden Aufträgen. Die Bridge läuft als Prozess auf demselben Rechner wie QGIS.
Womit gearbeitet wird, ist damit geklärt. Wie im Projekt gearbeitet wird, steht in einer eigenen Datei.
Belege
Konzept 05 · Fachkontext
Instruktionsdateien
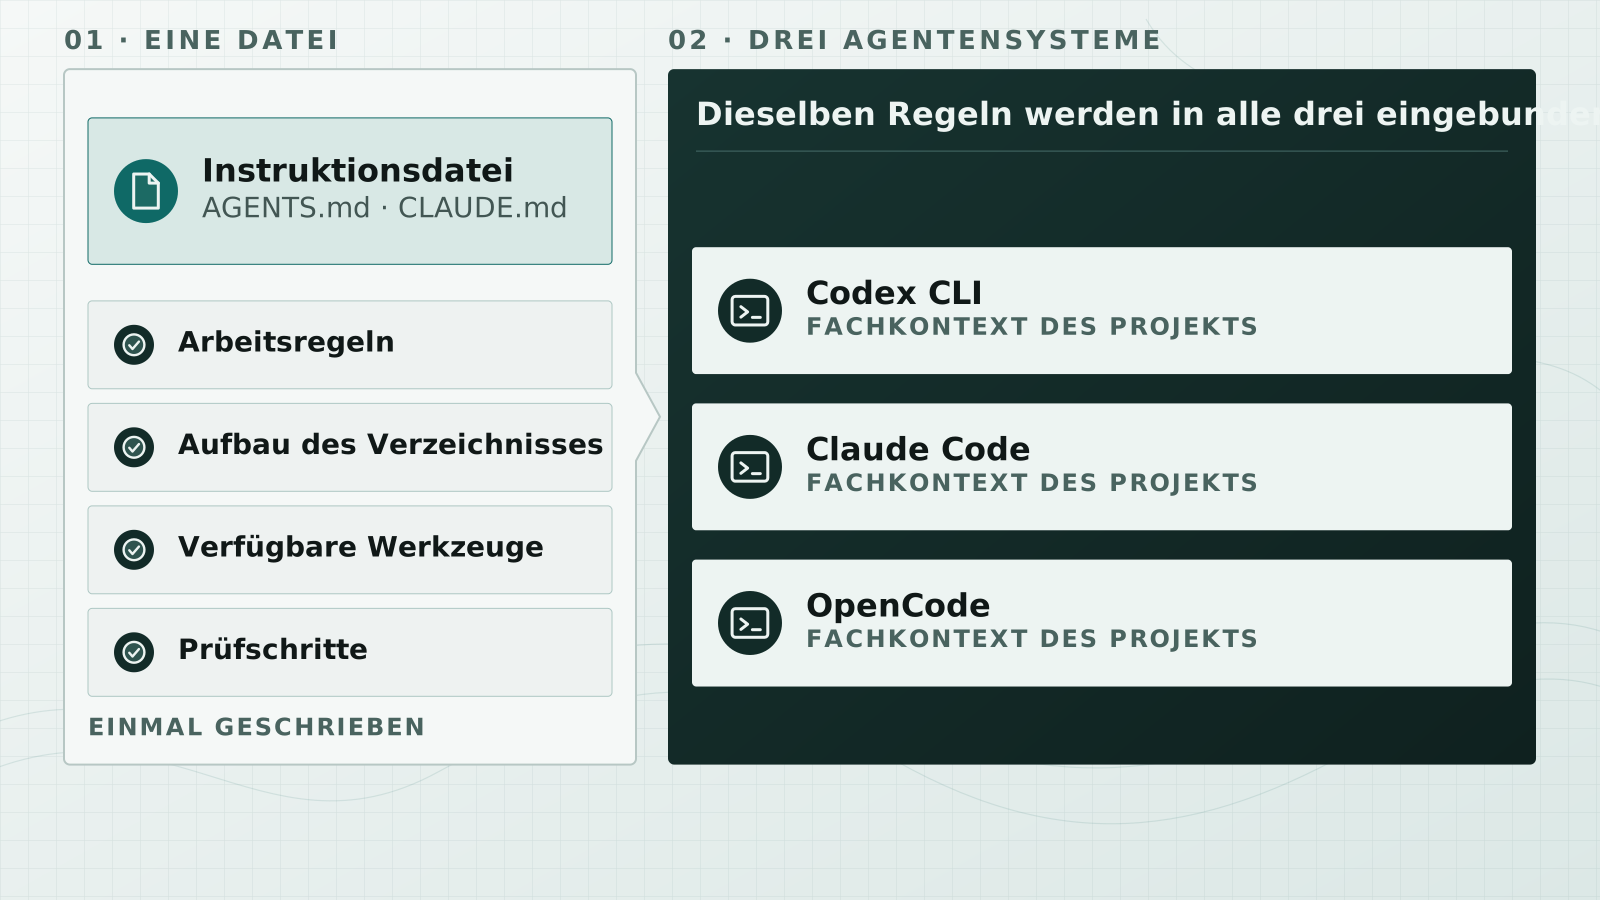
Bevor ein Agent arbeitet, liest er eine Datei mit Anweisungen, die im Projekt liegt; jeder der drei Coding-Agenten kennt eine solche Datei unter seinem eigenen Namen. Darin steht, wie im Projekt gearbeitet wird.
Üblicherweise stehen vier Dinge darin: die Regeln der Arbeit, der Aufbau des Verzeichnisses, die verfügbaren Werkzeuge und die Prüfungen, die ein Ergebnis bestehen muss.
Bei SpatialAgents gibt es diesen Fachkontext nur einmal. Codex, Claude Code und OpenCode lesen denselben Text und arbeiten nach denselben Regeln, und wer die Arbeitsweise ändert, ändert eine Datei statt drei Konfigurationen.
Das gilt für das ganze Projekt. Fachwissen für einzelne Aufgaben steht woanders und wird erst geladen, wenn es gebraucht wird.
Belege
Konzept 06 · Fachkontext
Skills
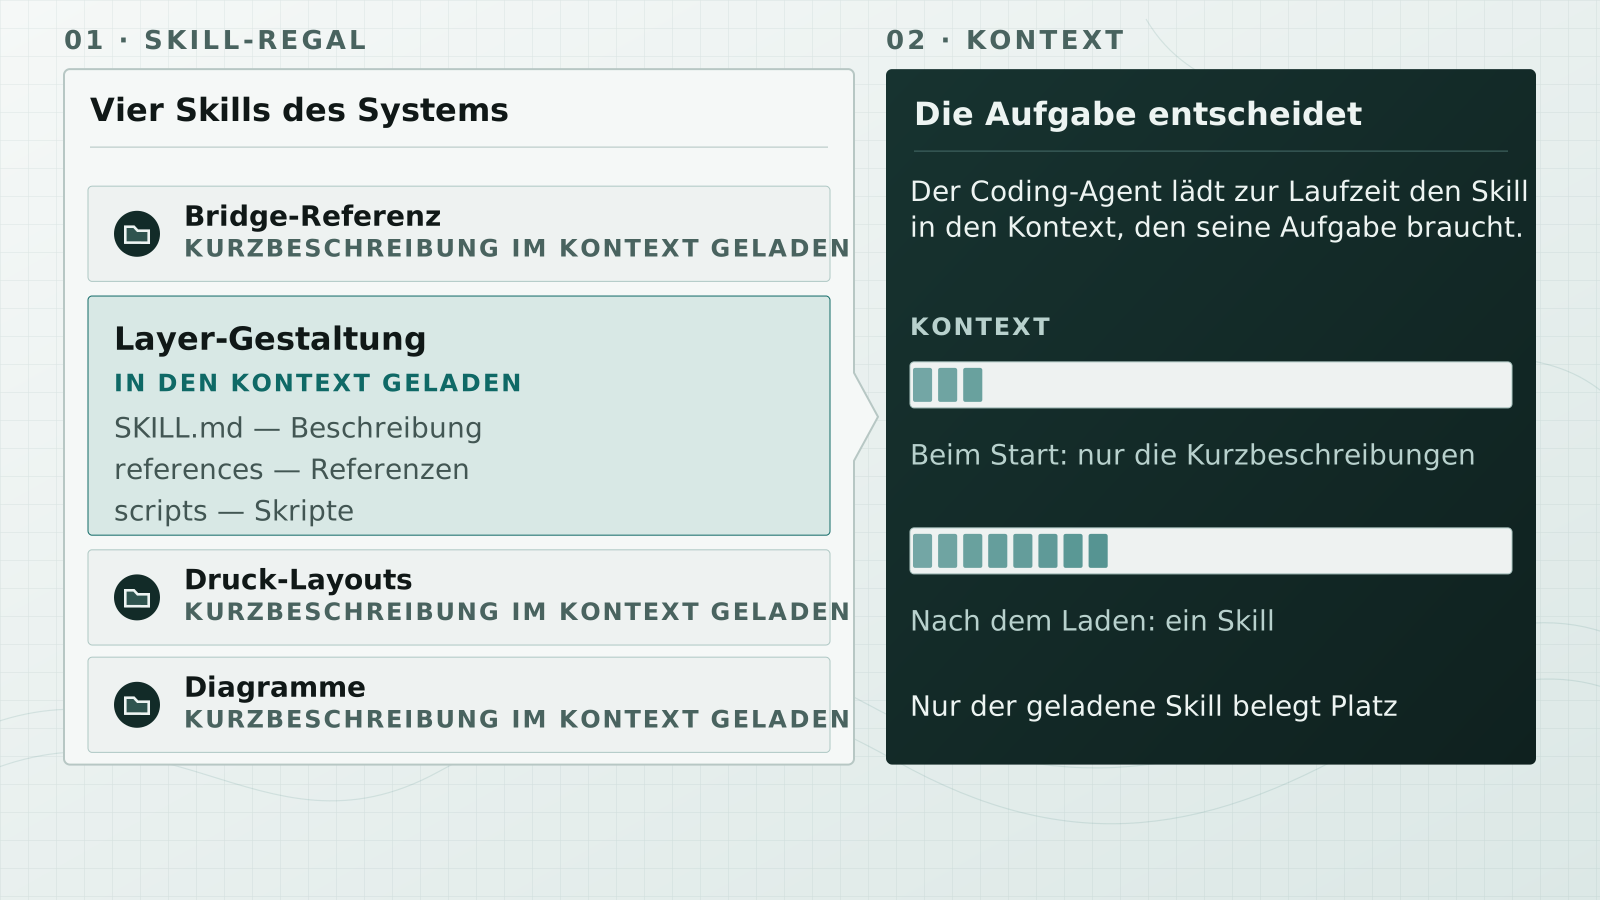
Ein Skill ist Fachwissen in einem Ordner: eine Beschreibung, dazu Referenzen und Skripte. Ein Agentensystem liest zu Beginn nur die Beschreibungen, und erst wenn eine Aufgabe zu einem Skill passt, lädt es ihn in den Kontext.
Der Gewinn liegt im Kontext, denn was nicht geladen ist, belegt keinen Platz.
Vier Skills gehören zum System. Der erste beschreibt die Werkzeuge der Bridge, der zweite die Gestaltung von Layern, der dritte die Druck-Layouts und der vierte die Diagramme in der Karte.
Der Anwender sagt in normaler Sprache, was er braucht, und das Fachwissen dazu steht im Skill; QML oder Layout-Interna muss niemand kennen.
Damit ist beschrieben, was ein Agentensystem weiß. Wie es daraus einen Plan für eine große Aufgabe macht, zeigt die agentische Planung.
Belege
Konzept 07 · Fachkontext
Agentische Planung
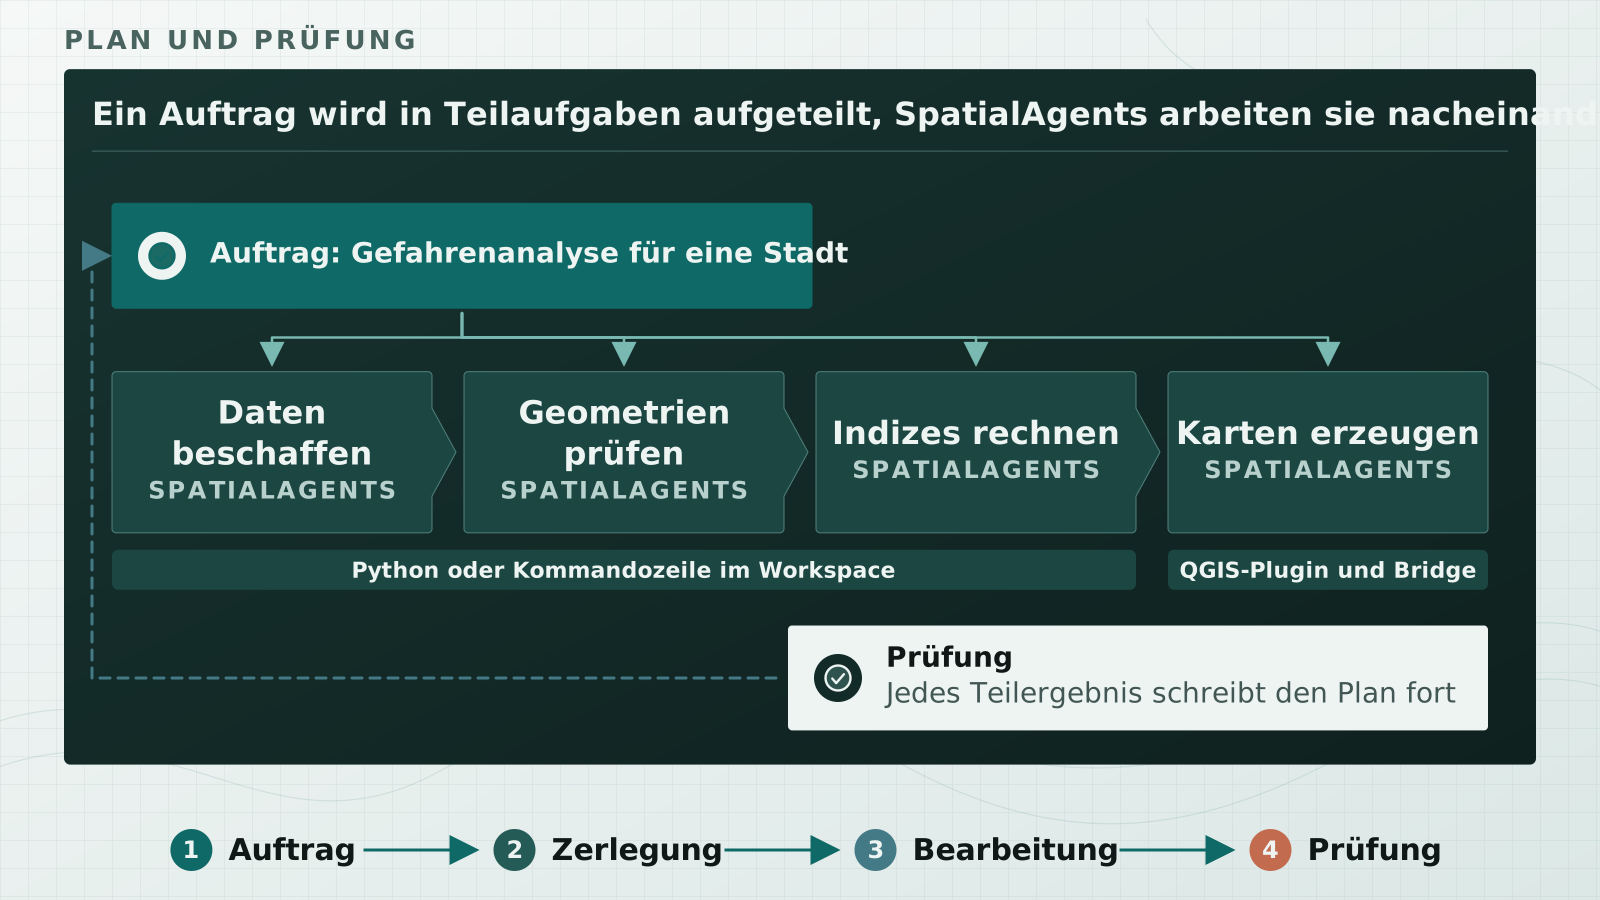
Eine Gefahrenanalyse für eine Stadt ist keine Aufgabe für einen Schritt. SpatialAgents zerlegen sie in vier Teilaufgaben, nämlich Daten beschaffen, Geometrien prüfen, Indizes rechnen und Karte erzeugen, und legen diese Zerlegung als Plan an. Die vier Teilaufgaben arbeiten sie nacheinander ab: drei davon mit Python oder auf der Kommandozeile im Workspace, die Karte über das QGIS-Plugin und die Bridge. Der Plan bleibt dabei die Mitte der Arbeit und wird nach jedem Teilergebnis fortgeschrieben. Eine Prüfung, die nicht aufgeht, führt zum Auftrag zurück und erzeugt einen weiteren Schritt. Der Plan entsteht, bevor die Arbeit beginnt.
Belege
- Benchmark 08: Aufgabe in acht Phasen, Plan vor der Arbeit, höchstens zwei Wiederholungen je Phase
- Benchmark 08: Kriterium „Initialer Plan vorhanden und nachvollziehbar“, 5 Punkte
- Claude Code: Planmodus in den Arbeitsabläufen
- Codex CLI: Dokumentation, Planen vor der Änderung
- OpenCode: Agenten-Dokumentation mit dem Plan-Agenten
Konzept 07 · Teil 2
Der Plan entsteht vor der Arbeit
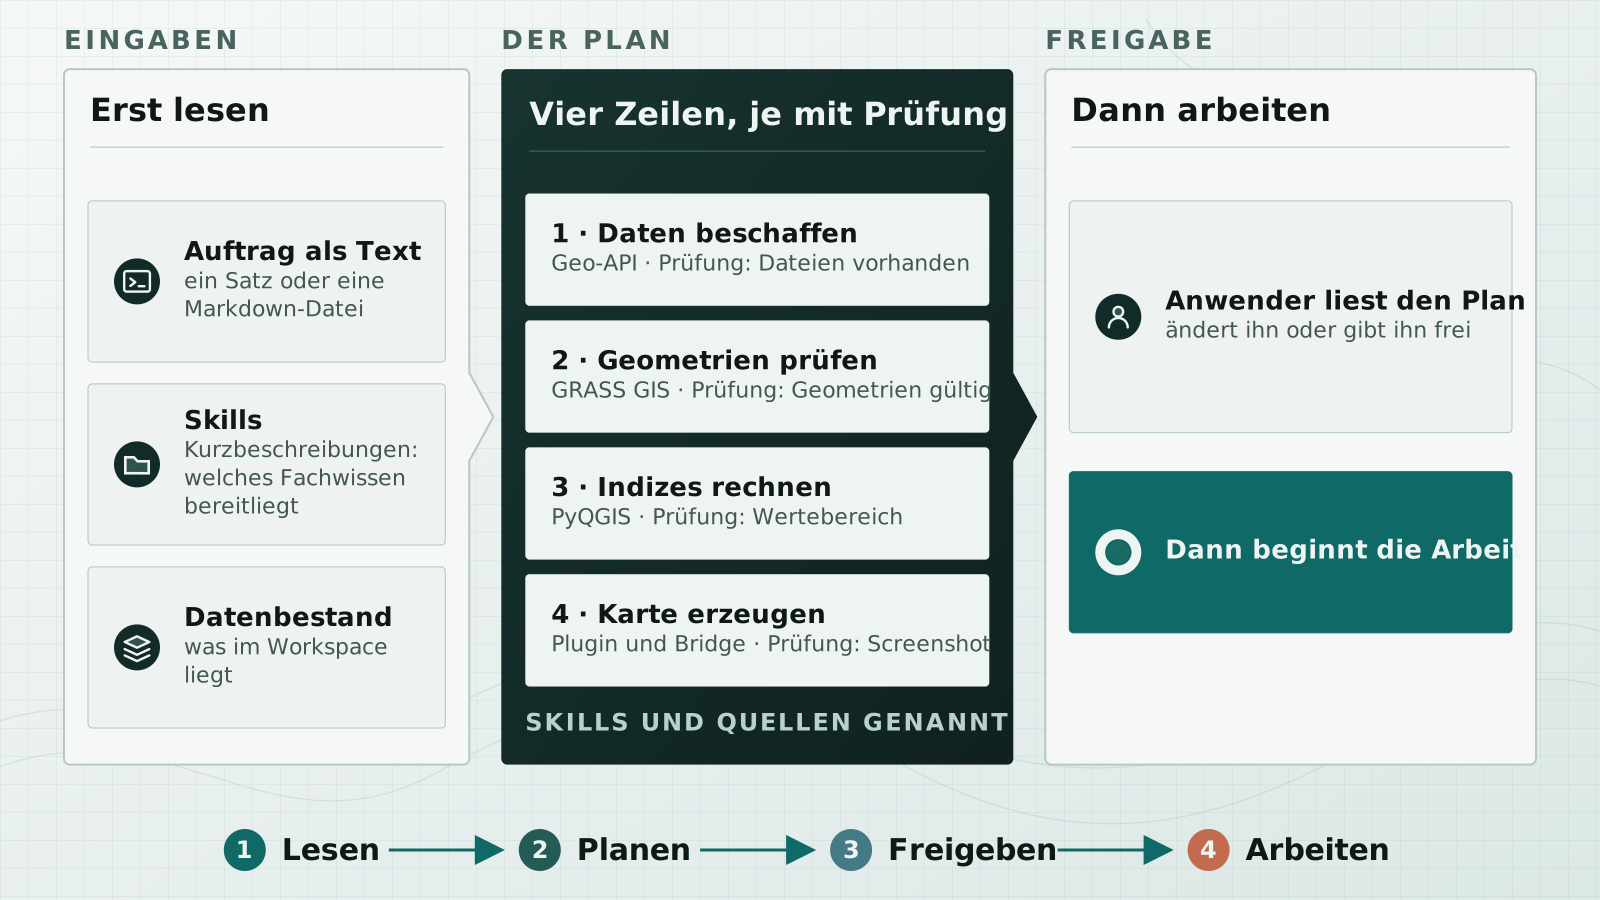
Bevor ein Coding-Agent eine Datei anfasst, liest er. Er liest den Auftrag, die Kurzbeschreibungen der Skills und den Datenbestand im Workspace.
Dann schreibt er den Plan. Der Plan nennt die Teilaufgaben in ihrer Reihenfolge. Zu jeder Teilaufgabe nennt er das Werkzeug und die Prüfung, mit der sie endet. Und er nennt die Skills und Datenquellen, die er dafür nutzt.
Alle drei Coding-Agenten kennen diesen Schritt. Claude Code hat dafür den Planmodus: Der Coding-Agent liest und schlägt einen Plan vor, ändert aber nichts, bis der Anwender zustimmt. OpenCode bringt einen eigenen Plan-Agenten mit, der nur liest. Codex nennt das Planen als ersten Schritt vor jeder Änderung.
Der Anwender liest den Plan, ändert ihn oder gibt ihn frei. Erst dann beginnt die Arbeit.
Jede Zeile des Plans endet mit einer Prüfung.
Belege
Konzept 07 · Teil 3
Jede Teilaufgabe endet mit einer Prüfung
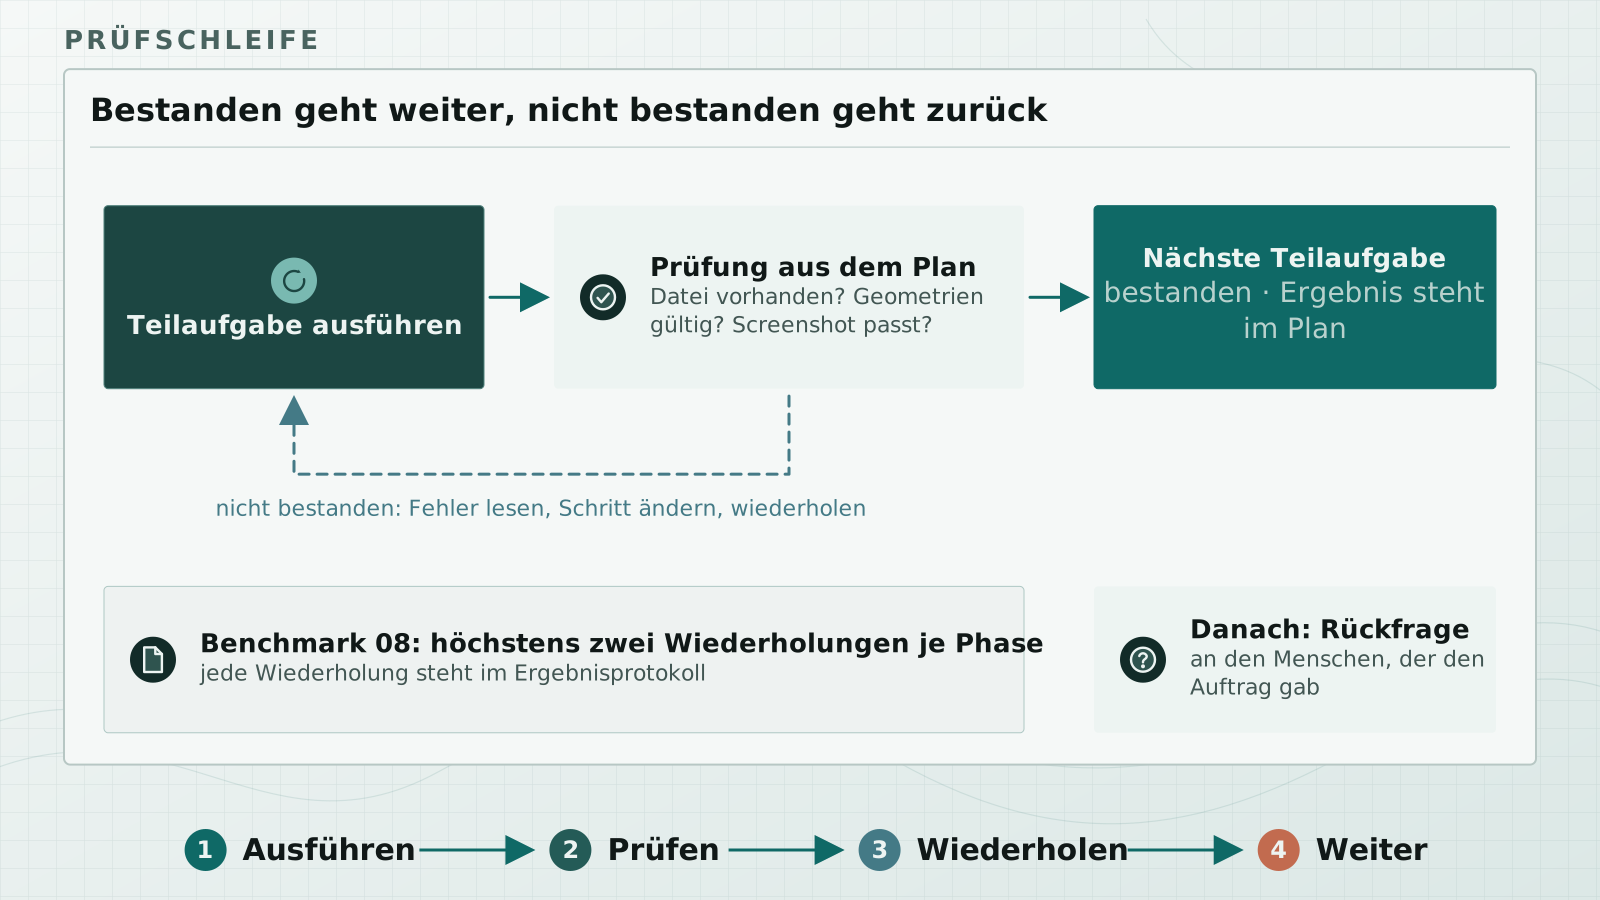
Der Plan nennt zu jeder Teilaufgabe eine Prüfung, bevor die Arbeit beginnt. Liegt die Datei vor? Sind die Geometrien gültig? Zeigt der Screenshot die Karte, die der Auftrag verlangt?
Besteht das Ergebnis, schreibt der Coding-Agent es in den Plan und geht zur nächsten Teilaufgabe.
Besteht es nicht, geht er zurück. Er liest die Fehlermeldung, ändert den Schritt und führt ihn noch einmal aus. Benchmark 8 erlaubt dafür höchstens zwei Wiederholungen je Phase, und jede Wiederholung steht im Ergebnisprotokoll.
Trägt auch die Wiederholung nicht, endet die Schleife an einer Rückfrage an den Menschen. Das ist die Regel aus dem ersten Abschnitt: Die Schleife endet an einem geprüften Ergebnis oder an einer Frage.
Wie ein solcher Plan in einer Messreihe aussieht, zeigt Benchmark 8.
Belege
Konzept 07 · Teil 4
Der Plan im Benchmark 08
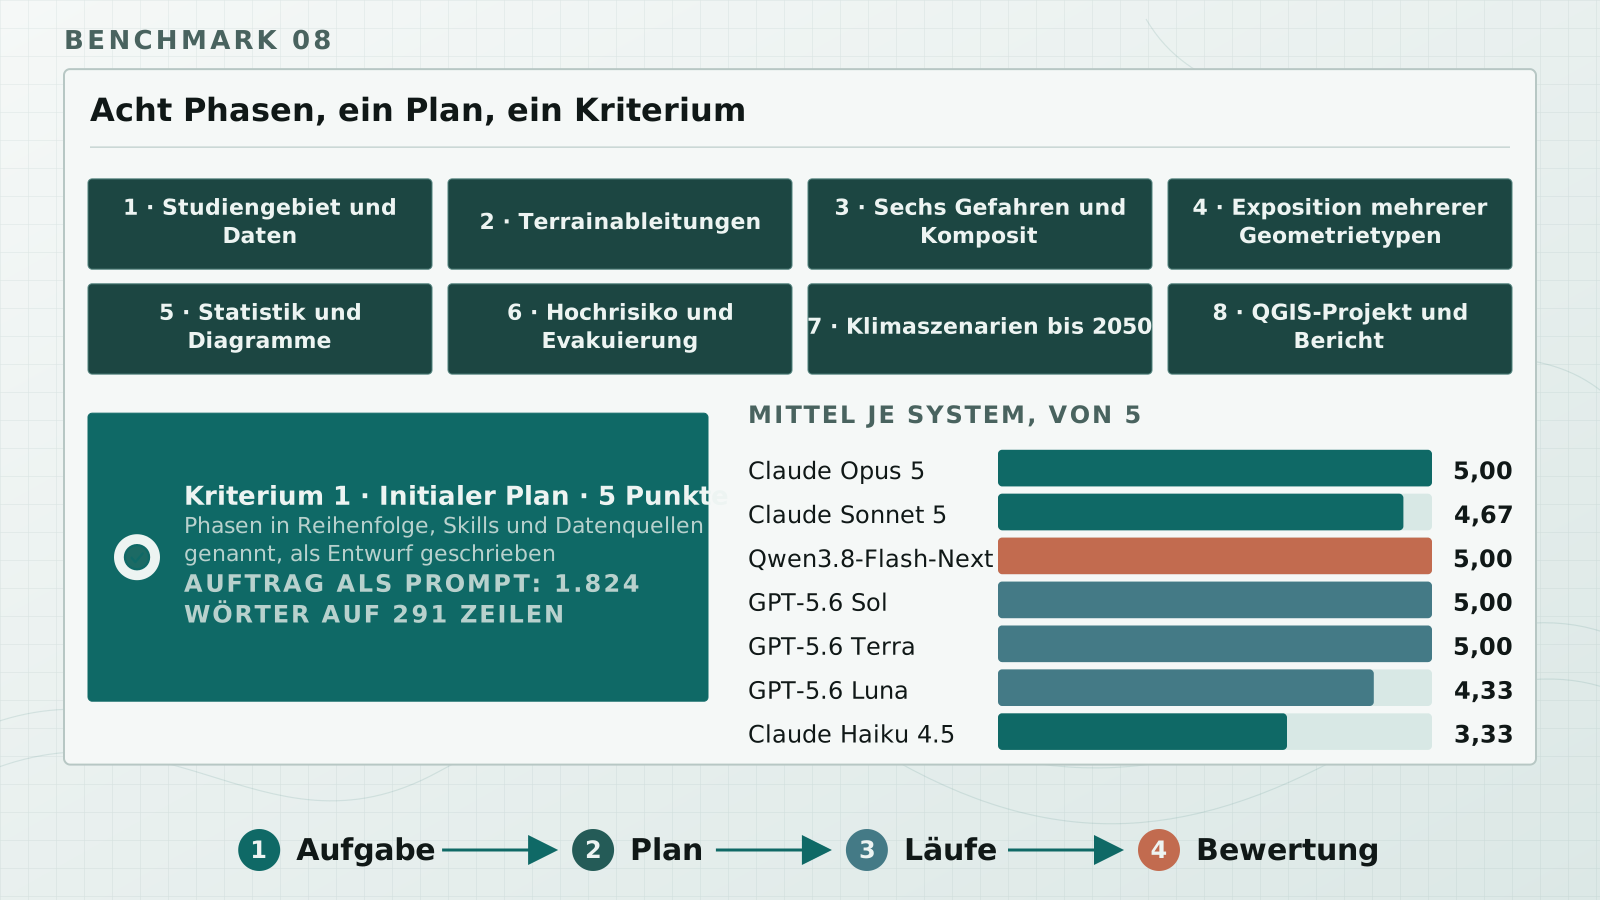
Die Aufgabe von Benchmark 8 kommt in acht Phasen, die mit Studiengebiet, Daten und Terrain-Ableitungen beginnen. Dann folgen sechs Gefahren und ihr Komposit, die Exposition mehrerer Geometrietypen sowie Statistik und Diagramme. Den Schluss bilden Hochrisiko und Evakuierung, die Klimaszenarien bis 2050 und das QGIS-Projekt mit Bericht. Jede Phase endet mit einem Screenshot.
Der Auftrag verlangt vor der Arbeit einen Plan, und das erste Kriterium der Bewertung gibt dafür fünf Punkte. Der Plan nennt die Phasen in ihrer Reihenfolge und die genutzten Skills und Datenquellen, und er liest sich als Entwurf, nicht als Zusammenfassung danach.
Vier der sieben Systeme holten in allen drei Läufen die vollen fünf Punkte; am unteren Ende lag Haiku mit gut drei Punkten im Mittel.
Der Plan ist der günstige Teil der Arbeit. Ob Teile davon nebeneinander laufen können, zeigt die nächste Folie.
Belege
Konzept 07 · Teil 5
Unabhängige Teile als weitere SpatialAgents
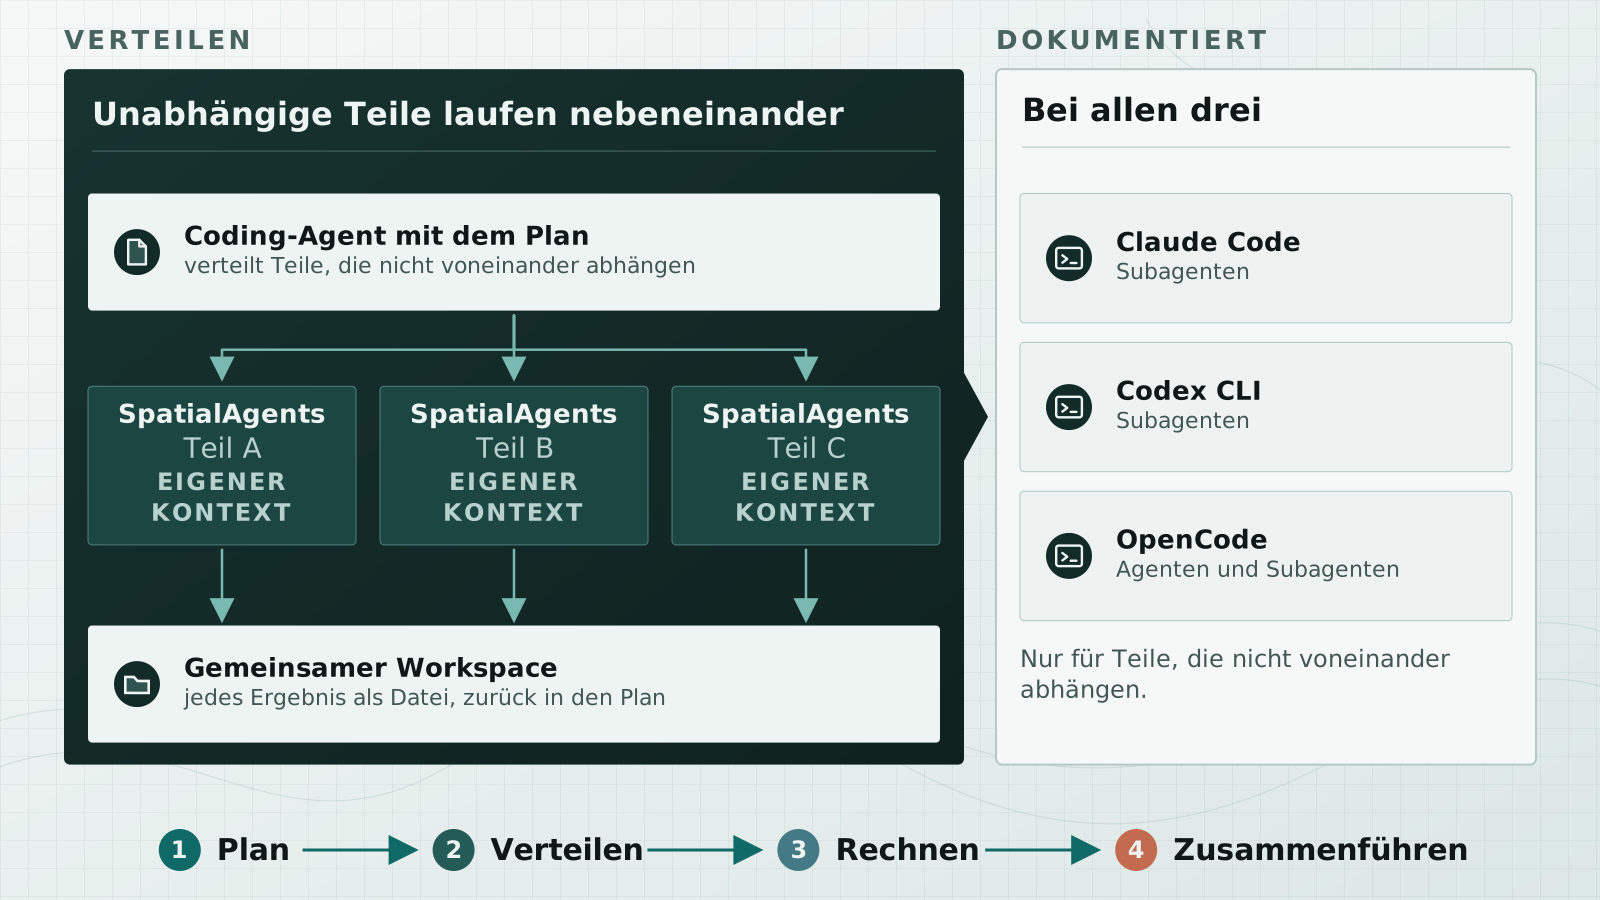
Manche Teilaufgaben hängen nicht voneinander ab. Ein Beispiel sind die sechs Gefahren-Indizes in Benchmark 8: Jeder entsteht aus den Basisdaten, keiner aus einem anderen Index.
Für solche Teile kann ein Coding-Agent weitere SpatialAgents starten. Jeder bekommt einen eigenen Auftrag und einen eigenen Kontext. Alle arbeiten im gemeinsamen Workspace und legen ihr Ergebnis als Datei ab. Der Plan bleibt bei dem Coding-Agenten, der sie gestartet hat. Er führt die Ergebnisse zusammen und geht zur nächsten Teilaufgabe.
Der Gewinn liegt im Kontext. Die Werkzeugergebnisse eines Teils landen im Kontext des weiteren SpatialAgents, nicht im Hauptkontext.
Alle drei Coding-Agenten dokumentieren das als Subagenten.
Was nach der Freigabe geschieht, zeigt der Ablauf einer Aufgabe.
Belege
Konzept 08 · System
Der Ablauf einer Aufgabe
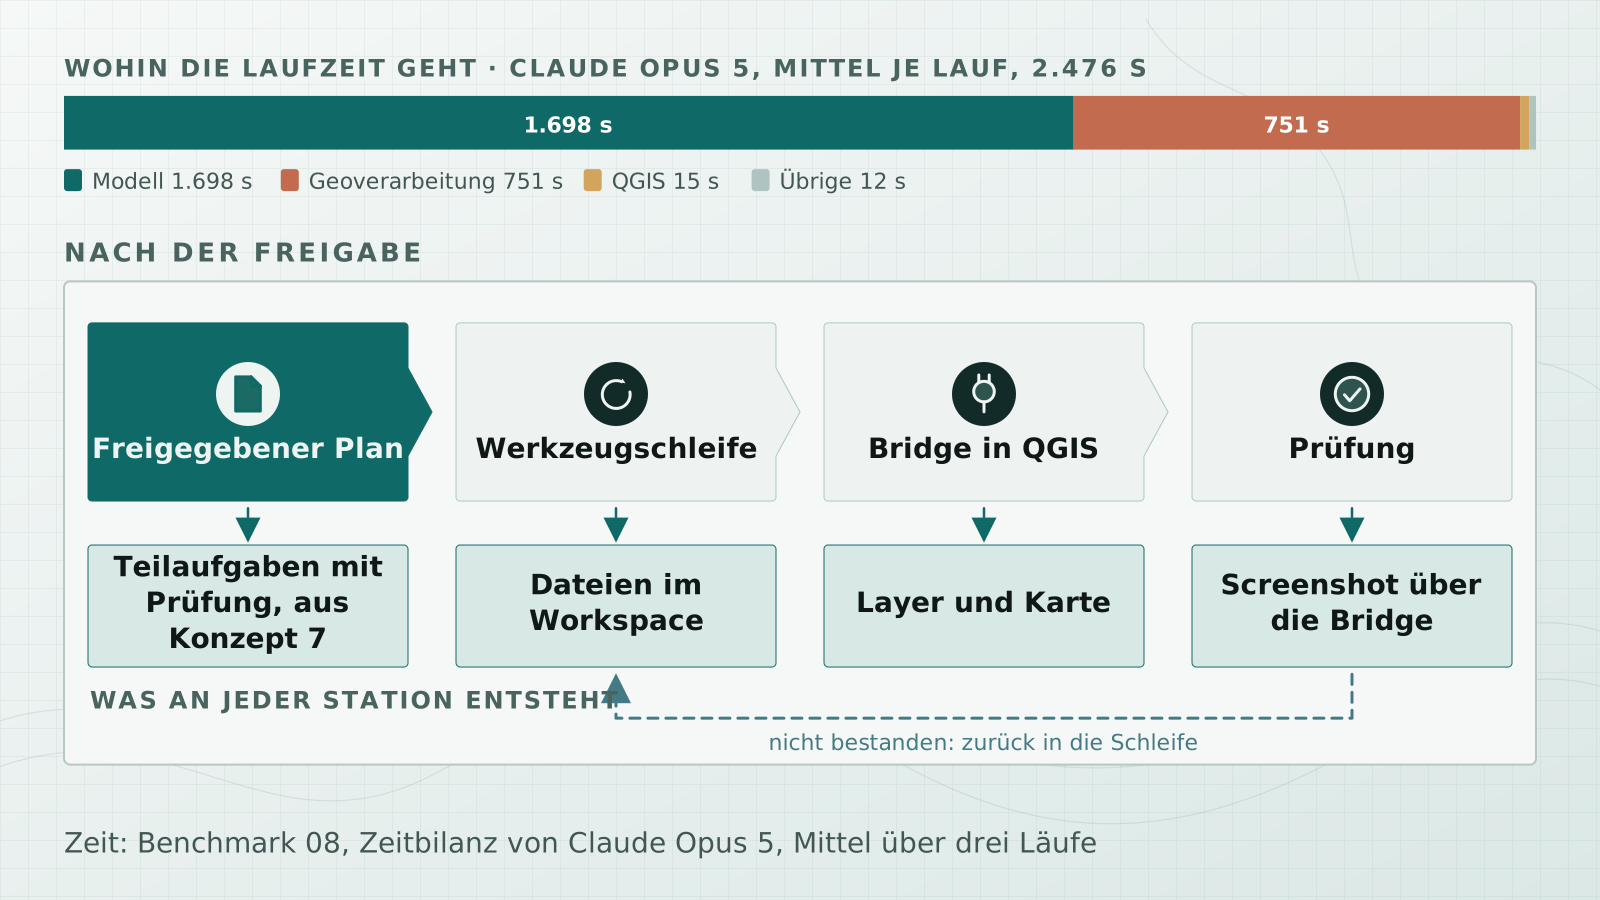
Der Plan ist freigegeben. Was dann geschieht, hat drei Stationen und eine Prüfung.
Zuerst läuft die Werkzeugschleife: Der Coding-Agent ruft Werkzeuge auf, und im Workspace entstehen Dateien. Der Workspace ist das gemeinsame Verzeichnis für SpatialAgents und QGIS, und gerechnet wird dort mit Python und auf der Kommandozeile.
Dann wirkt die Bridge in QGIS, wo aus den Dateien Layer werden und aus den Layern eine Karte.
Zum Schluss folgt die Prüfung, die der Plan für diese Teilaufgabe nennt. Die Bridge holt einen Screenshot und die Angaben zu den Layern aus QGIS, und passt das Ergebnis nicht, geht es zurück in die Schleife.
Die Zeit verteilt sich ungleich. Bei Opus entfielen von gut vierzig Minuten Laufzeit im Mittel mehr als zwei Drittel auf das Modell, knapp ein Drittel auf die Geoverarbeitung und nur wenige Sekunden auf QGIS.
Wie kurz der Rechenteil ausfällt, hängt an der Bibliothek, mit der gerechnet wird.
Belege
Konzept 09 · System
Geospatial API und Tokeneffizienz
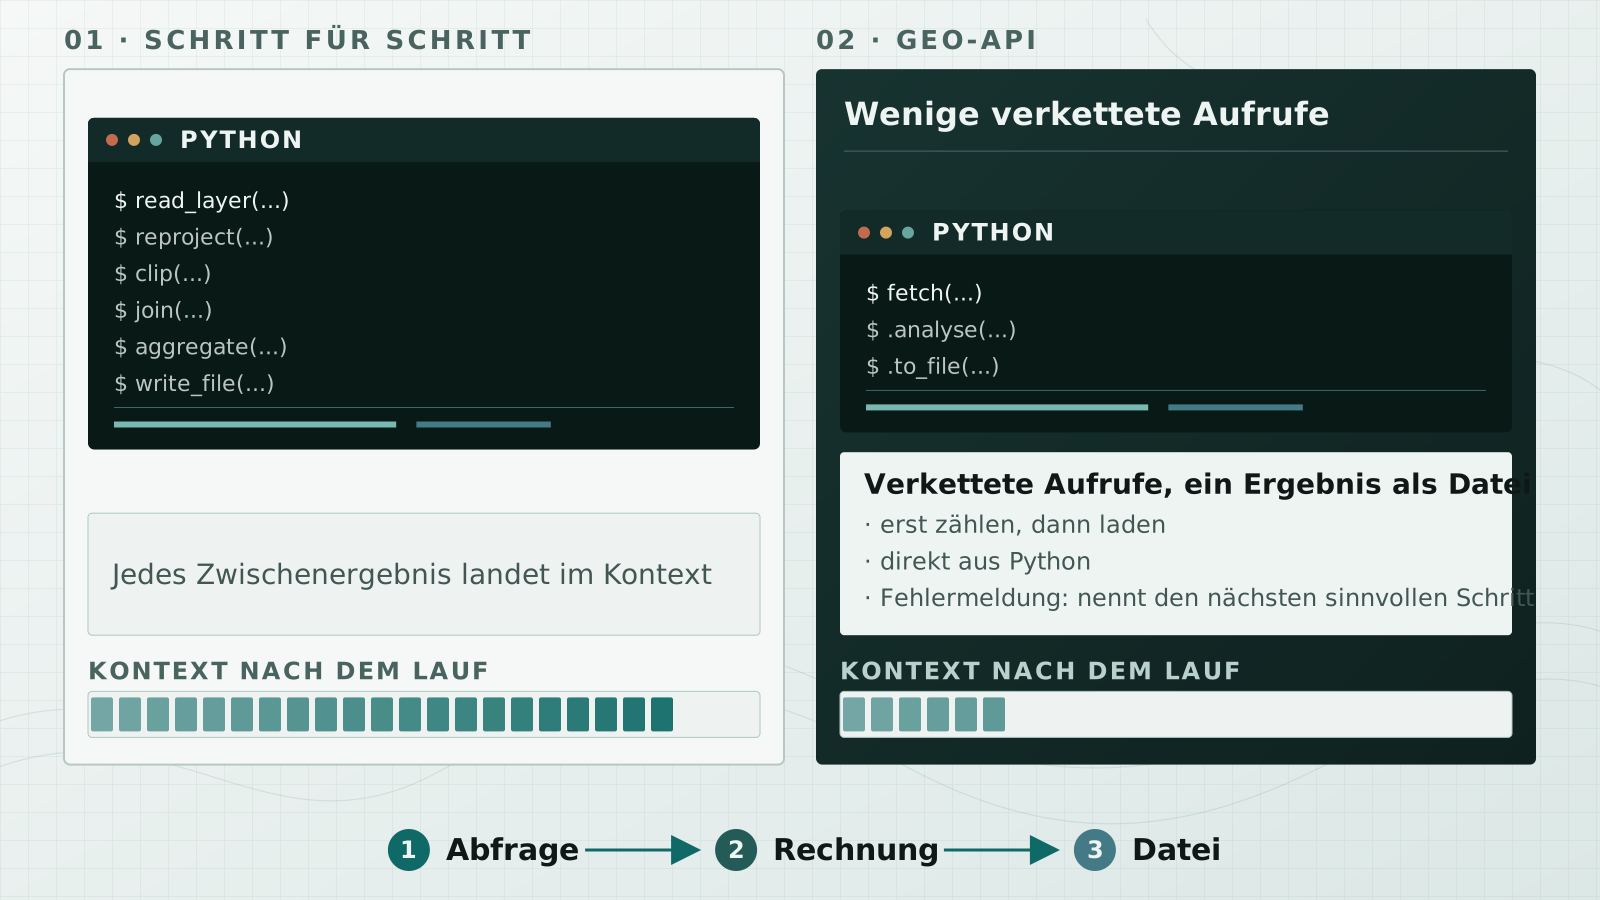
Die Geospatial API, kurz Geo-API, ist eine Python-Bibliothek, geschrieben für den Gebrauch durch Agenten. Ein Aufruf holt Daten, ein zweiter rechnet, und ein dritter schreibt das Ergebnis als Datei.
Ohne sie entsteht dieselbe Arbeit als lange Kette von Einzelschritten, bei der jeder Schritt ein Zwischenergebnis liefert und jedes Zwischenergebnis im Kontext landet.
Vier Eigenschaften senken den Tokenaufwand. Die Aufrufe sind deklarativ und lassen sich aneinanderhängen. Vor dem Laden lässt sich zählen, wie viele Objekte eine Abfrage trifft. Fehlermeldungen nennen den nächsten sinnvollen Schritt. Und der Aufruf geht direkt aus Python oder von der Kommandozeile heraus, ohne Umweg über einen Werkzeug-Wrapper.
Die Geo-API stand in den Läufen der Messreihen zur Verfügung.
Damit ist der Rechenteil beschrieben. Der Weg zurück nach QGIS führt über Plugin und Bridge.
Belege
Konzept 10 · System
Plugin und Bridge
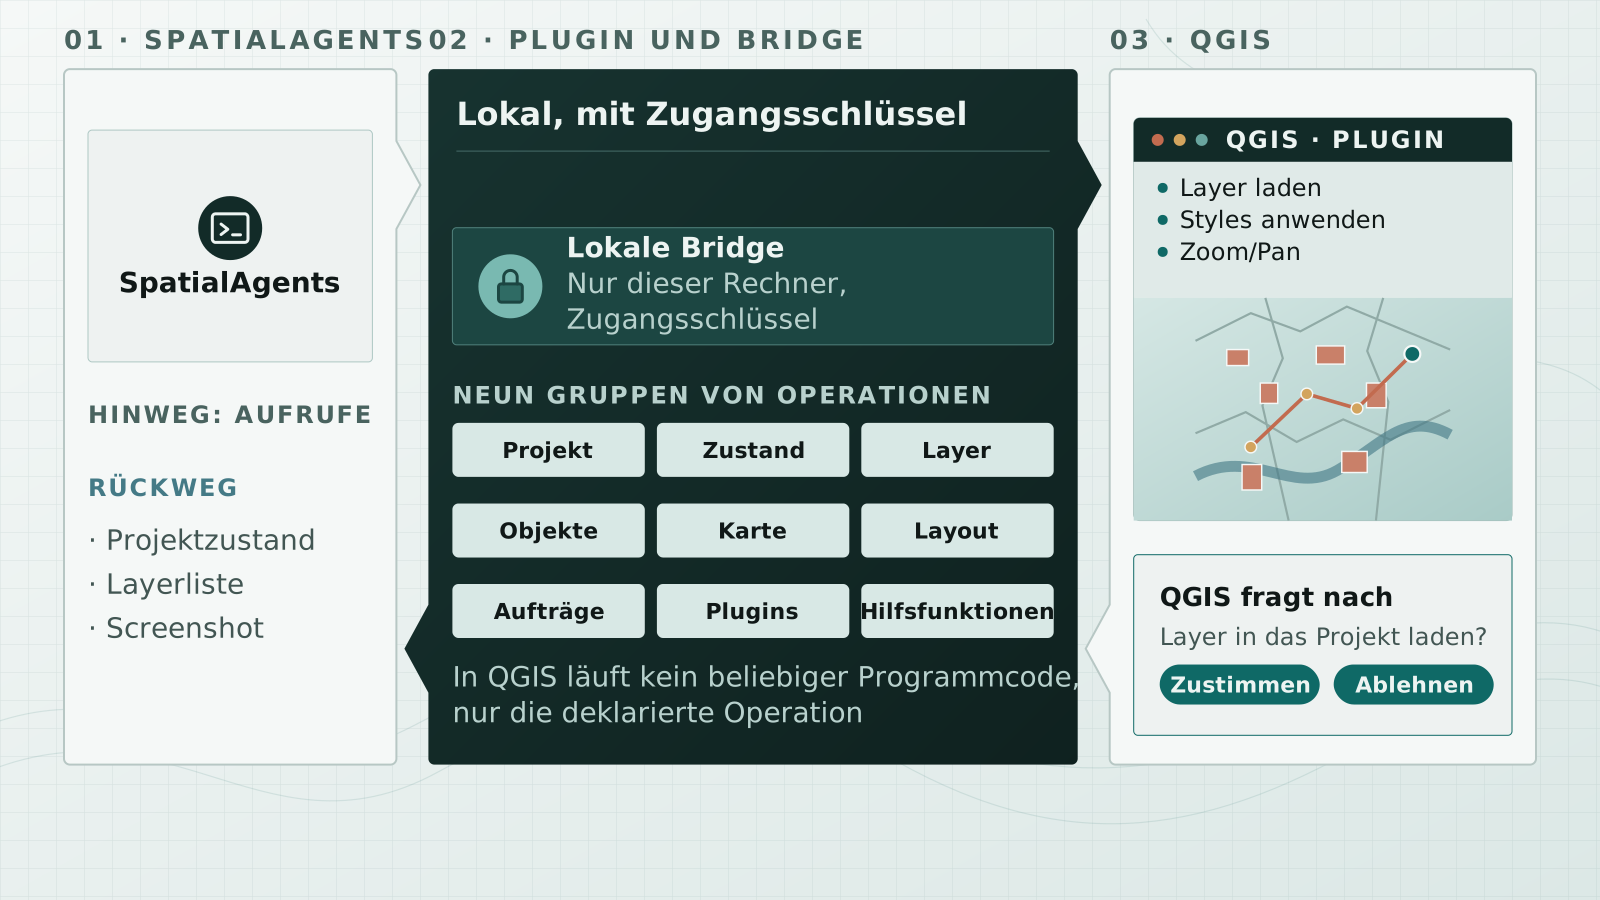
Das Plugin macht das geöffnete QGIS-Projekt für SpatialAgents erreichbar. Es öffnet eine Verbindung, die nur auf diesem Rechner gilt und einen Zugangsschlüssel verlangt.
Über diese Verbindung kommen Werkzeugaufrufe an, und die Bridge setzt sie in QGIS-Operationen um: Sie lädt Layer, gestaltet sie, bewegt die Karte und baut Druck-Layouts.
Zurück gehen drei Dinge, nämlich der Zustand des Projekts, die Liste der Layer und ein Bild der Karte. Dieses Bild ist die Art, wie ein Coding-Agent sein eigenes Ergebnis ansieht.
Zwei Grenzen gelten dabei. Eingriffe, die das Projekt verändern, legt QGIS dem Anwender zur Bestätigung vor, und in QGIS läuft kein beliebiger Programmcode, sondern nur die deklarierte Operation.
Gerechnet wird deshalb an einer anderen Stelle.
Belege
Konzept 11 · System
Steuern und Rechnen
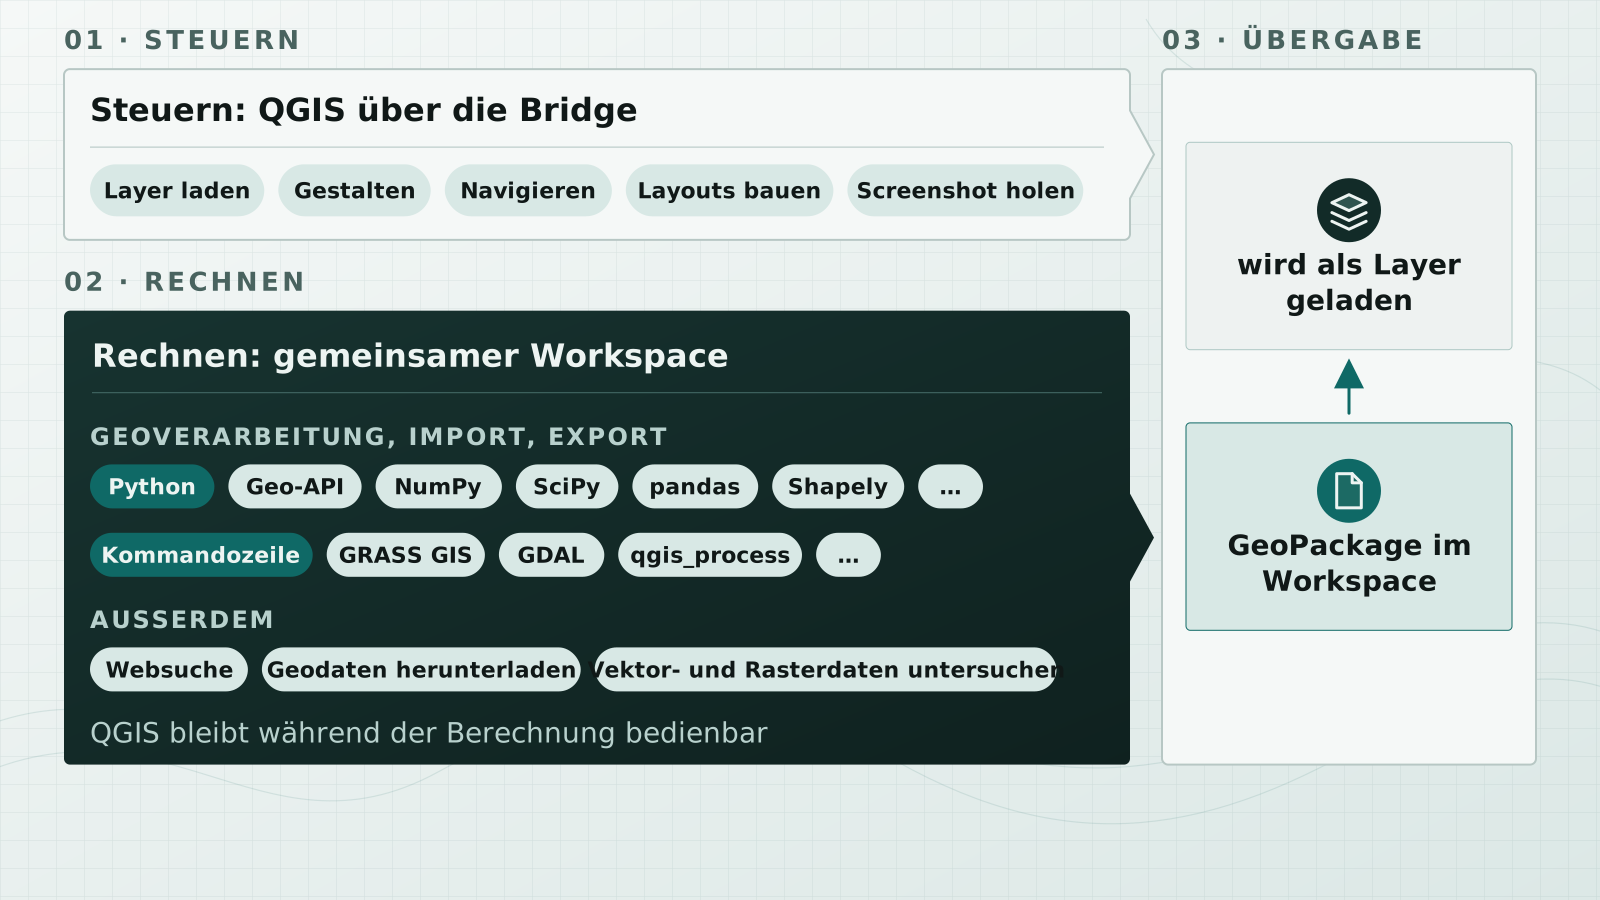
SpatialAgents trennen zwei Arten von Arbeit: das Steuern von QGIS und das Rechnen mit Geodaten.
Gesteuert wird über die Bridge: Layer laden, gestalten, die Karte bewegen, ein Druck-Layout bauen, einen Screenshot holen.
Gerechnet wird im Workspace: mit Python-Bibliotheken, mit Kommandozeilenwerkzeugen, dazu Websuche, Datendownload und die Prüfung vorhandener Vektor- und Rasterdaten.
Das hat zwei Folgen. QGIS bleibt bedienbar, weil keine lange Rechnung die Oberfläche anhält. Und jedes Ergebnis liegt als Datei vor, die sich unabhängig vom Projekt öffnen und nachrechnen lässt.
An einer Stelle treffen sich beide Bahnen. Im Workspace entsteht ein GeoPackage, und die Bridge lädt es als Layer in das Projekt.
Offen ist noch, wo das Sprachmodell dabei rechnet.
Belege
Konzept 12 · Betrieb und Beleg
Lokal oder Cloud
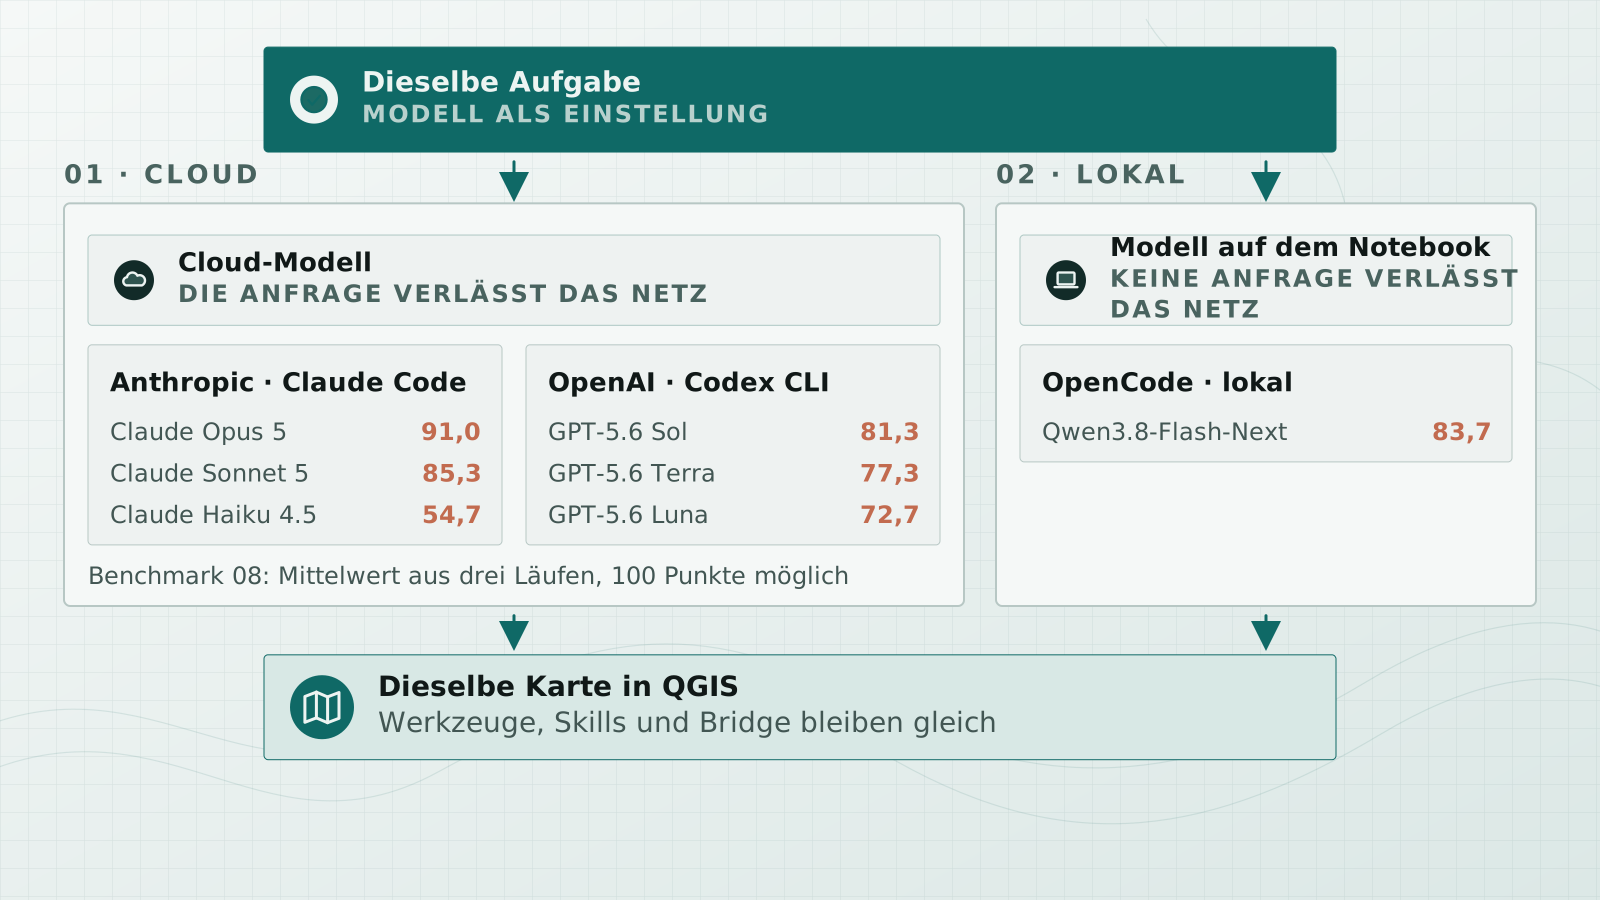
Welches Sprachmodell rechnet, ist eine Einstellung. Dieselbe Aufgabe läuft mit einem Modell in der Cloud oder mit einem Modell auf dem eigenen Notebook, während Werkzeuge, Skills und die Verbindung zu QGIS dieselben bleiben.
Der letzte Abschnitt stellt eine Messreihe vor, Benchmark 8. Sie hat beide Wege gemessen und jeden Lauf nach denselben Kriterien auf einer Skala von hundert Punkten bewertet. Sieben Systeme aus Agent und Modell lösten dieselbe Gefahren- und Klimaanalyse für Stuttgart, jedes davon drei Mal.
Eines dieser Modelle lag dabei auf dem Schreibtisch: Qwen lief auf einem Notebook, erreichte knapp 84 von hundert Punkten und lag damit vor allen drei Cloud-Modellen von OpenAI.
Im lokalen Betrieb verlässt keine Anfrage das eigene Netz, und beide Wege führen zur selben QGIS-Karte.
Ob ein System die Aufgabe löst, entscheidet die Messung.
Belege
Konzept 13 · Betrieb und Beleg
Belege durch Messreihen
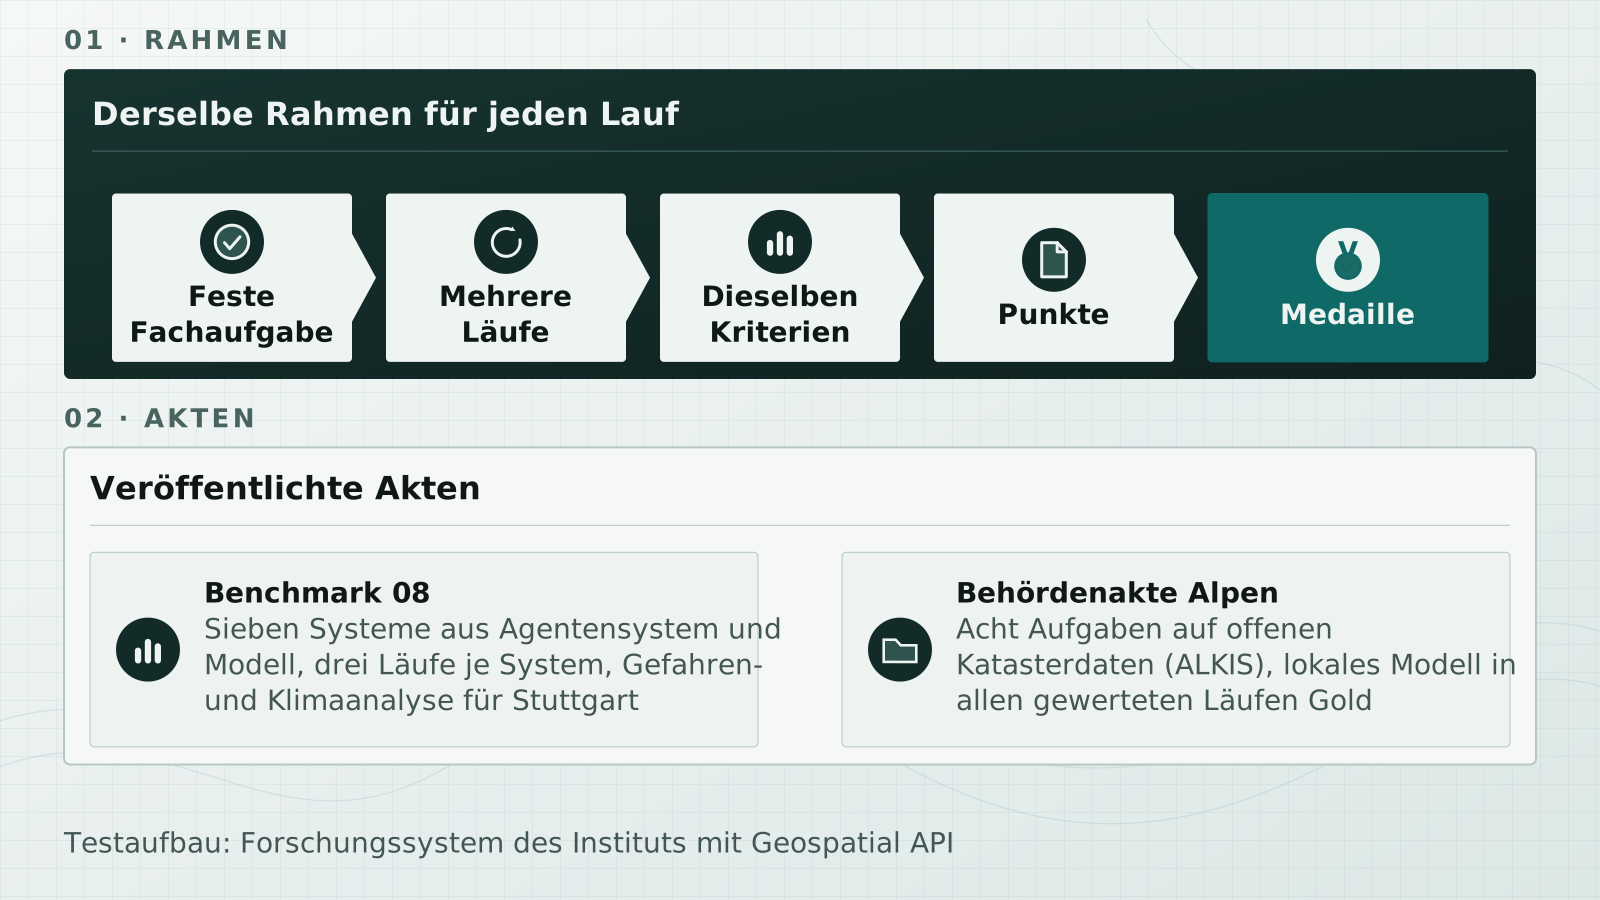
Ob ein System eine Aufgabe löst, zeigt eine Messreihe, und dafür gibt es Benchmarks.
Ein Benchmark ist eine feste Fachaufgabe mit einem Bewertungsrahmen. Jedes Modell bearbeitet sie mehrmals, jeder Lauf wird nach denselben Kriterien bewertet, und aus den Punkten wird eine Medaille.
Zwei Akten sind veröffentlicht. Die erste heißt Benchmark 8: Sieben Systeme aus Agent und Modell lösen dieselbe Gefahren- und Klimaanalyse für Stuttgart, jedes System drei Mal.
Die zweite ist die Behördenakte Alpen mit acht Aufgaben aus dem Amtsalltag auf offenen Katasterdaten, ALKIS, der Gemeinde Alpen am Niederrhein. Sonnet aus der Cloud trat gegen Qwen auf einem Notebook an, und das lokale Modell holte in allen gewerteten Läufen Gold.
Die Läufe nutzten das Forschungssystem mit zusätzlichen Fachskills für Geoprocessing und der Geospatial API.
Die beiden Akten zeigen die Ergebnisse im Einzelnen.
Belege
- Benchmark 08: sieben Systeme und ihre Läufe
- Benchmark 08: Aufgabe und Bewertungskriterien
- Behördenakte Alpen: Ergebnisse der acht Aufgaben
Konzept 13 · Teil 2
Benchmark 08: Punkte nach Modell
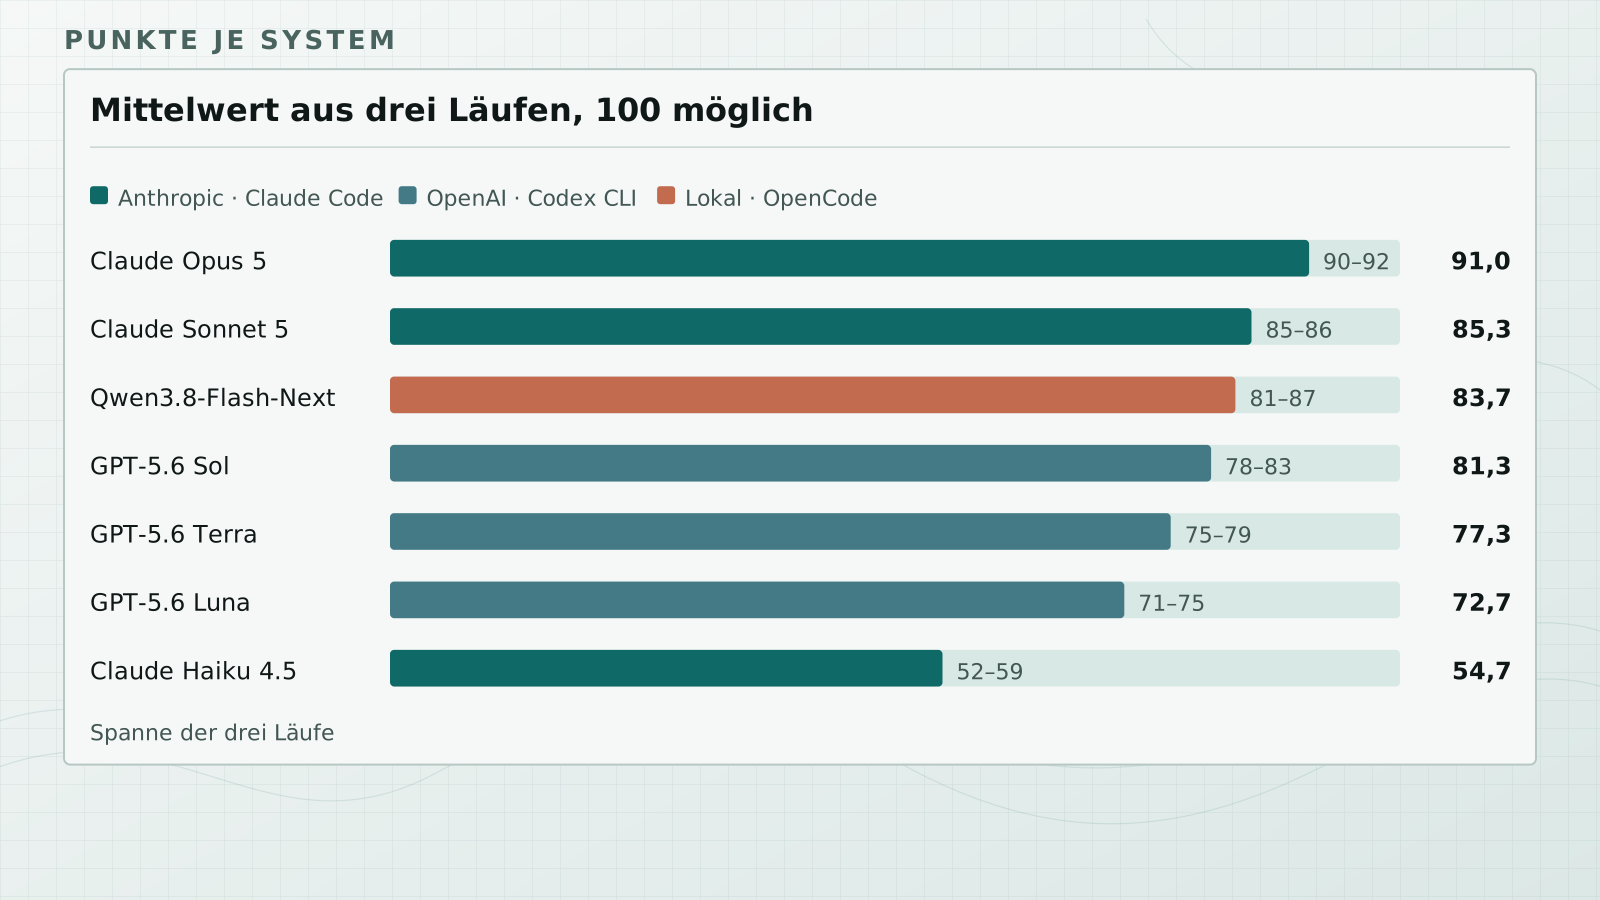
Benchmark 8 hat sieben Systeme gemessen. Jedes System lief dreimal, und jeder Lauf bekam Punkte auf einer Skala bis hundert. Die Spanne der drei Läufe steht neben jedem Balken.
Die Spanne ist groß: Vorn liegt Opus mit 91 Punkten im Mittel, am Ende Haiku mit knapp 55, und dazwischen stehen Sonnet, Sol, Terra und Luna.
Auf Platz drei steht das lokale Modell. Qwen erreicht knapp 84 Punkte und liegt damit vor allen drei Cloud-Modellen von OpenAI, obwohl es auf einem Notebook lief.
Was die Läufe an Token und Geld gekostet haben, zeigt die nächste Folie.
Belege
Konzept 13 · Teil 3
Benchmark 08: Token und Kosten je Lauf
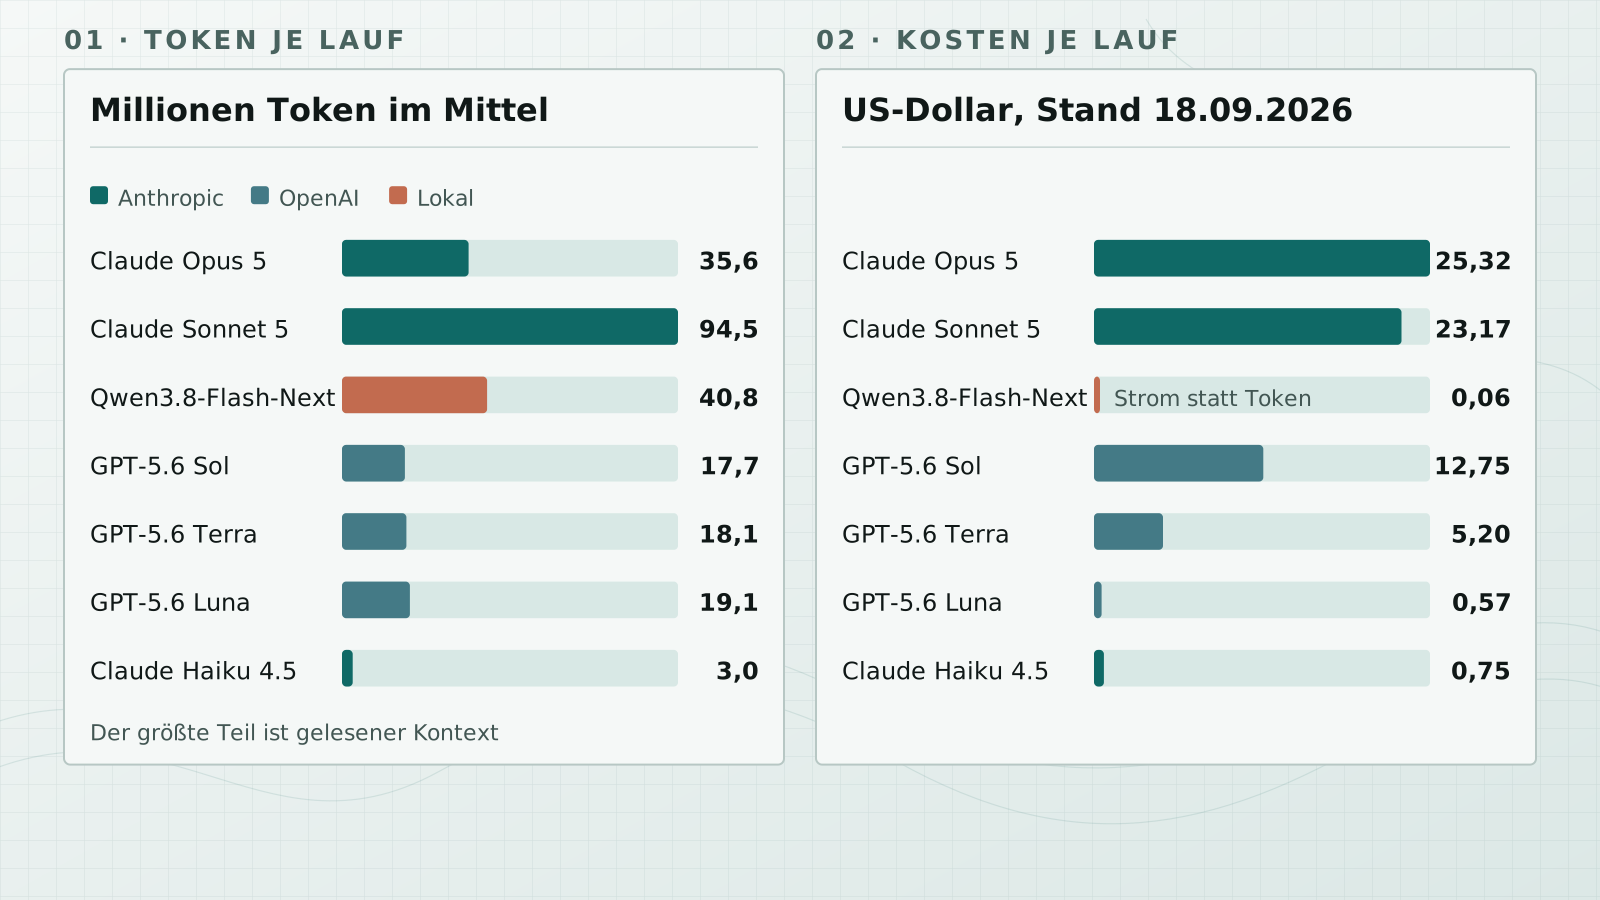
Dieselbe Aufgabe kostet je nach Modell sehr unterschiedlich viel Kontext.
Am meisten liest Sonnet mit gut 94 Millionen Token je Lauf, am wenigsten Haiku mit drei Millionen; die drei Modelle von OpenAI liegen bei knapp 20 Millionen. Der größte Teil davon ist gelesener Kontext, nicht Ausgabe.
In Geld heißt das, Stand September 2026: Der teuerste Lauf kostet bei Opus gut 25 US-Dollar, der günstigste Cloud-Lauf bei Luna gut einen halben Dollar. Der lokale Lauf mit Qwen zahlt Strom statt Token, sechs Cent.
Mehr Token bedeuten nicht mehr Punkte, denn Sonnet liest fast dreimal so viel wie Opus und erreicht weniger.
Wie viele Werkzeugaufrufe dahinterstehen und wie lange ein Lauf dauert, zeigt die nächste Folie.
Belege
Konzept 13 · Teil 4
Benchmark 08: Werkzeugaufrufe und Laufzeit
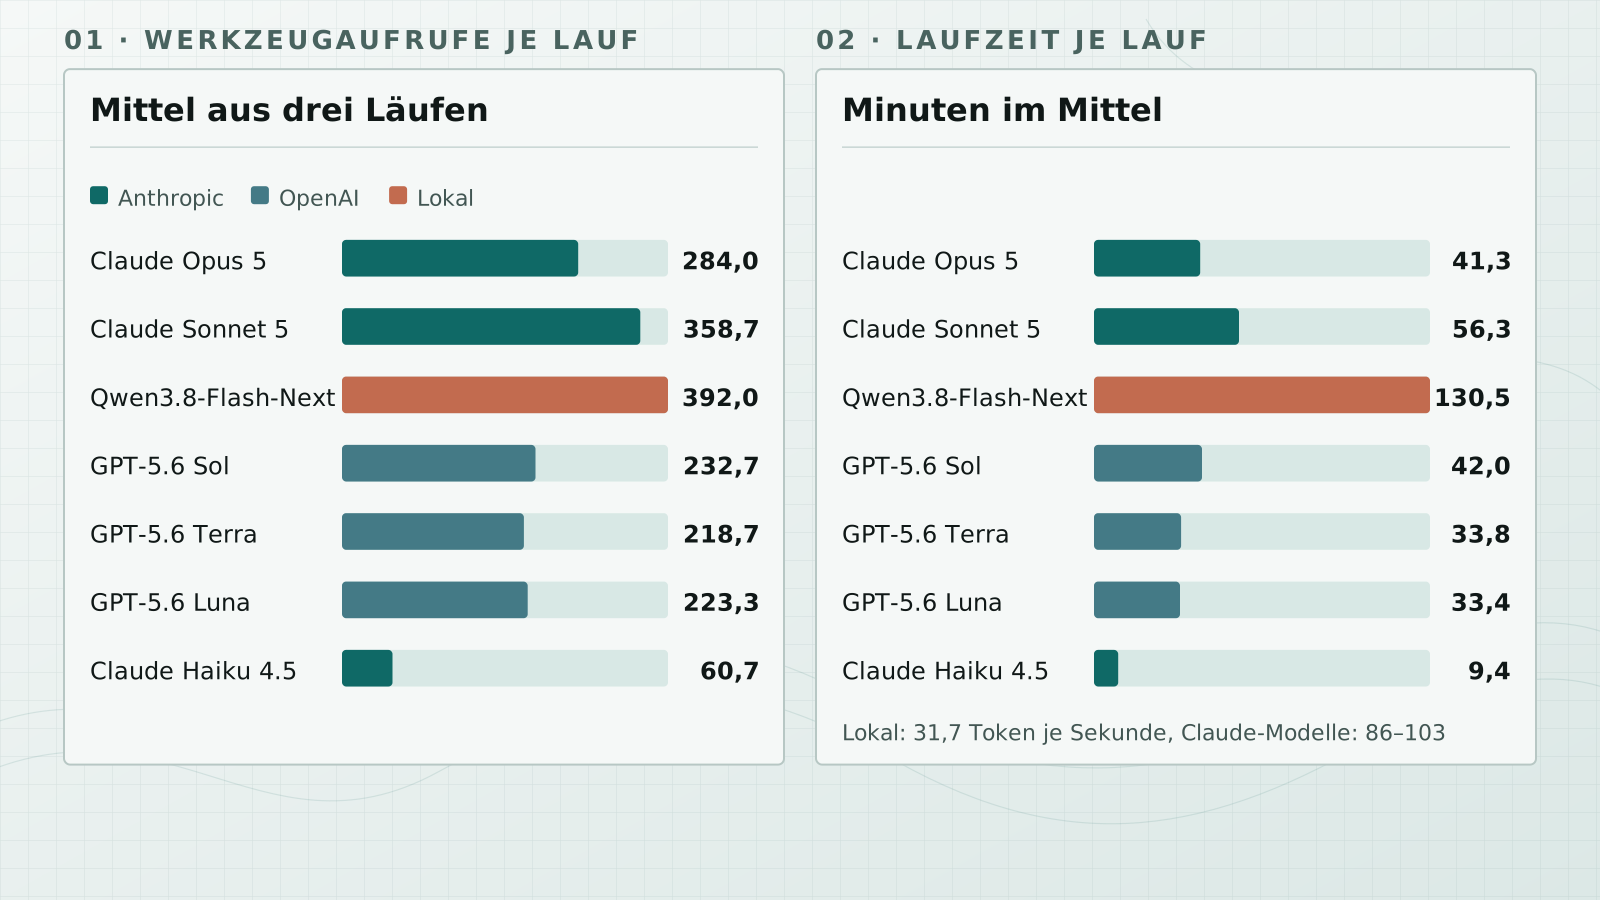
Ein Lauf besteht aus hunderten Werkzeugaufrufen. Die meisten braucht Qwen mit knapp 400 je Lauf, die wenigsten Haiku mit gut 60, und die übrigen fünf Modelle liegen zwischen 220 und 360.
Die Laufzeit ist an der Wanduhr gemessen. Haiku ist nach gut neun Minuten fertig, Qwen braucht mit knapp 130 Minuten am längsten, und die Cloud-Modelle von OpenAI und Anthropic liegen zwischen einer halben Stunde und einer Stunde.
Beim lokalen Modell geht der größte Teil der Zeit an das Modell selbst, weil es mit gut 30 Token je Sekunde rechnet, während die Claude-Modelle auf 86 bis 103 kommen.
Mehr Aufrufe bedeuten nicht mehr Zeit: Sol braucht weniger Aufrufe als Opus und ist trotzdem später fertig.
Die Benchmarkakte zeigt die Läufe im Einzelnen.
Belege
Weiter
Von hier aus weiter.
Diese Seite zeigt den Stand der Forschungs- und Entwicklungsarbeit am System. Projekte, Einrichtung, Schulung und Betreuung bietet die Geoinformatikbüro Dassau GmbH (GBD) ↗ an.